¿Con qué está hecho beam?
beam es un repo de Java hecho con Flask, flutter_web_plugins, JetBrains, Apache, javax.servlet:javax.servlet-api y 5 más. Guarda sus datos en MongoDB, SQLite y MySQL, inicia sesión con firebase_auth, firebase_auth_platform_interface, com.azure:azure-identity, cryptography y golang.org/x/oauth2, usa IA con openai-java-core, tf-keras, TensorFlow, tensorflow-transform y OpenAI, se conecta a Google, arma su contenido con flutter_svg, org.apache.tika:tika-core, pillow y markdown, valida sus datos con Pydantic y beartype, se prueba con mockserver-client-java, pytest-asyncio, junit:junit, Pytest, github.com/google/go-cmp y 15 más, corre en producción con log4j-slf4j-impl, slf4j-jdk14, org.slf4j:slf4j-api, cloud.google.com/go/logging, github.com/aws/aws-sdk-go-v2 y 3 más y usa avatica-core, calcite-druid, ClickHouse, client-v2, go.mongodb.org/mongo-driver y 51 más. Son 2,314,803 líneas escritas, con 3,825 archivos de prueba.
 LinkedIn
Leído el 16 de noviembre de 2026, en el commit 8ab5661. Léela en markdown
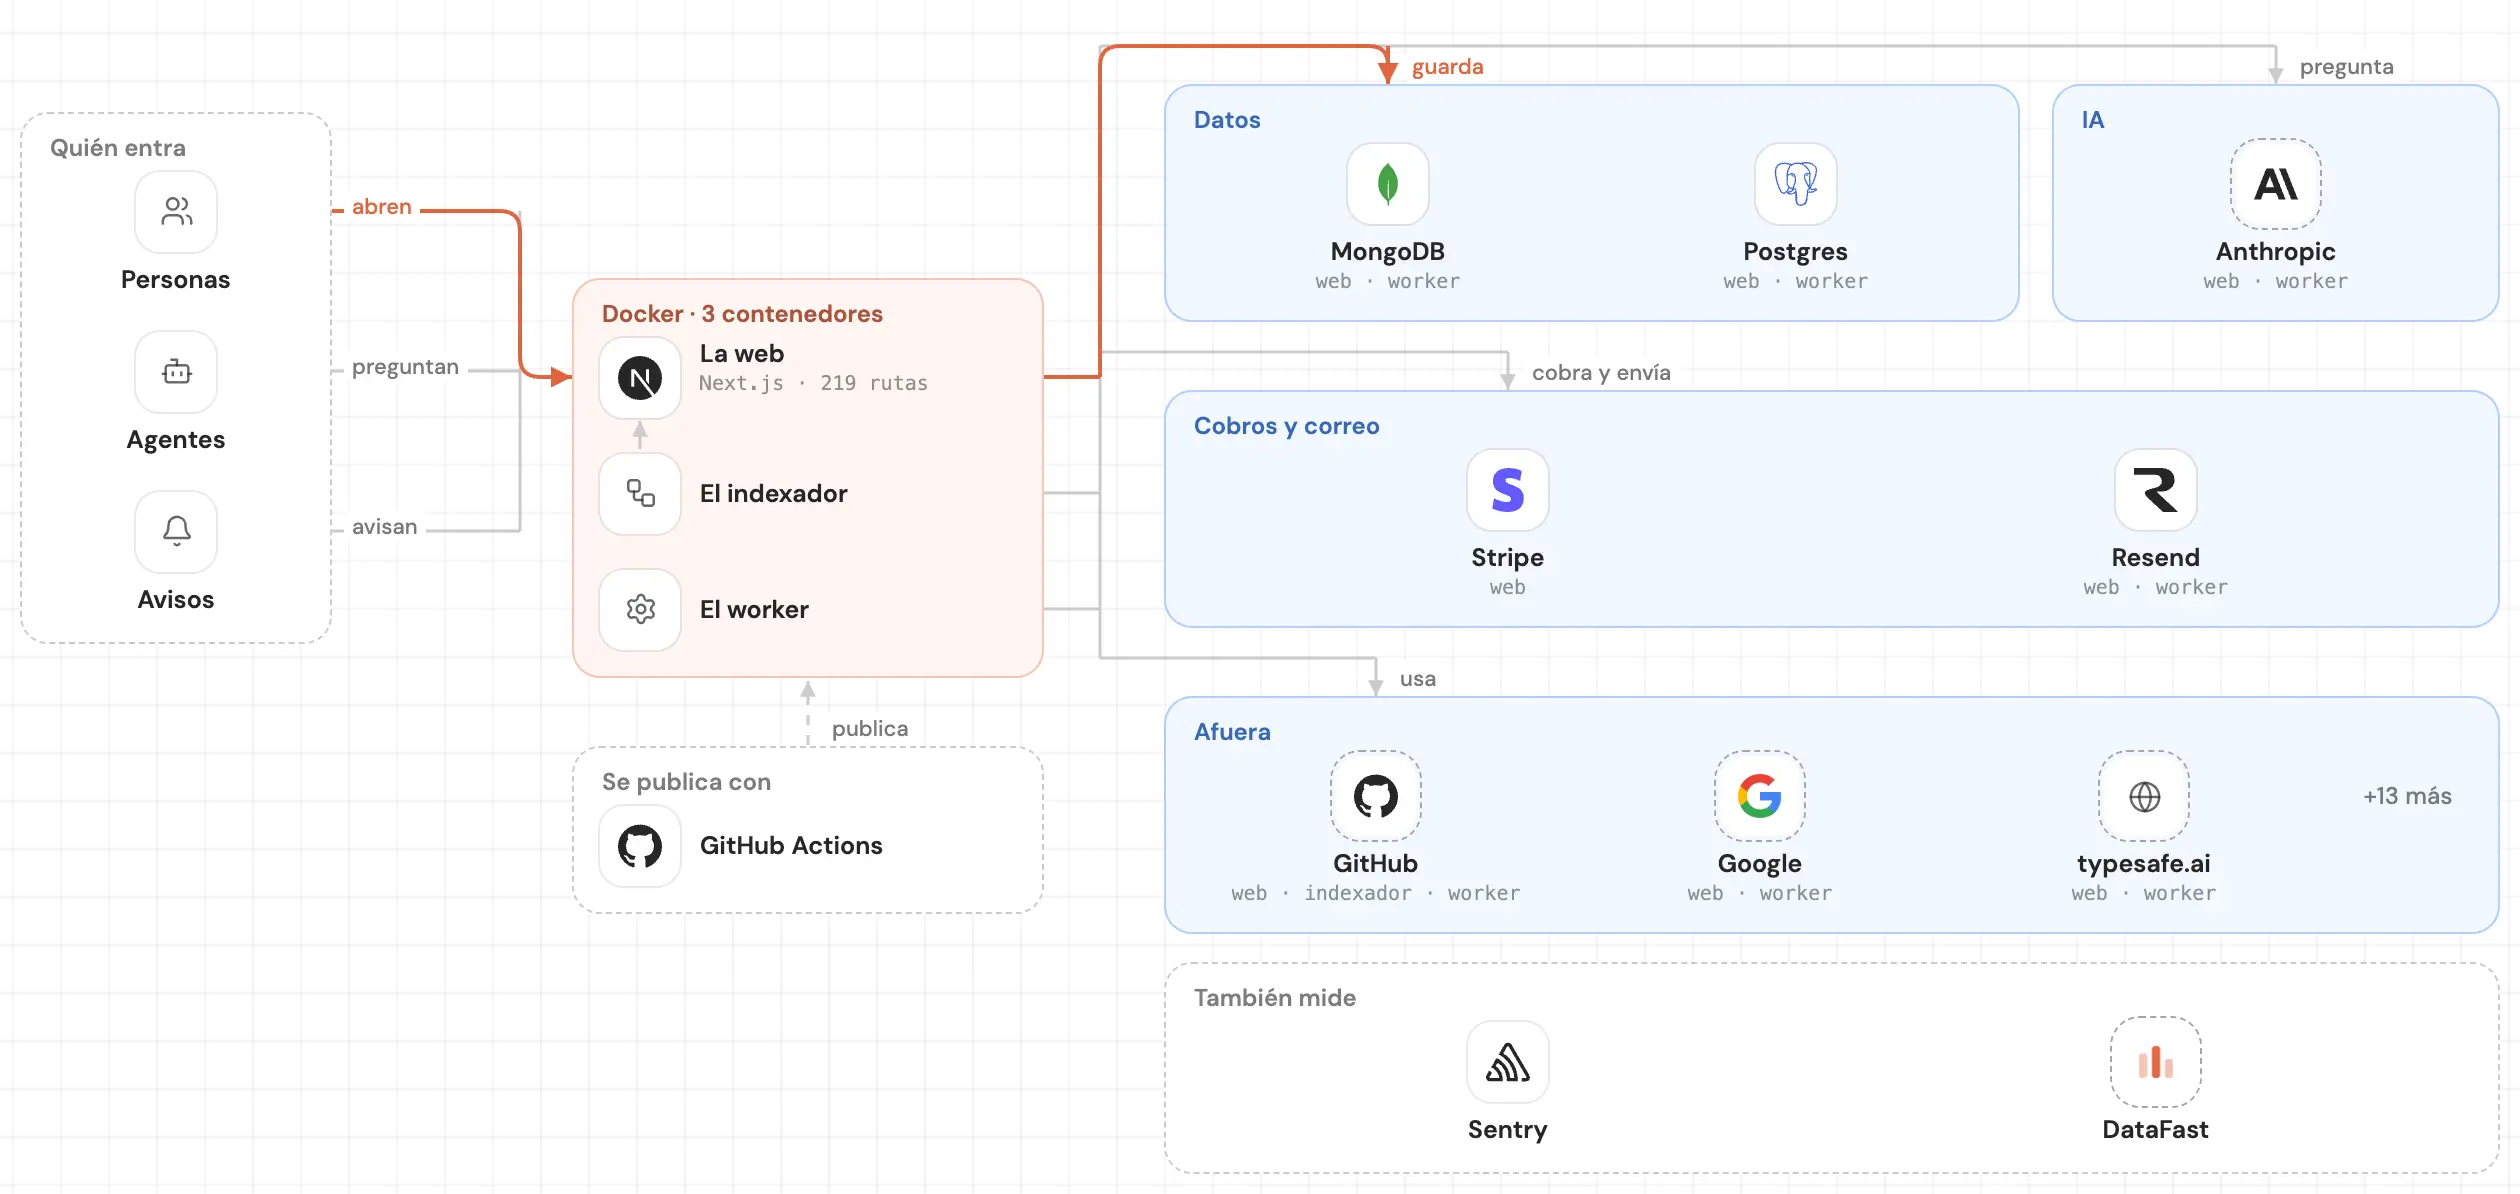
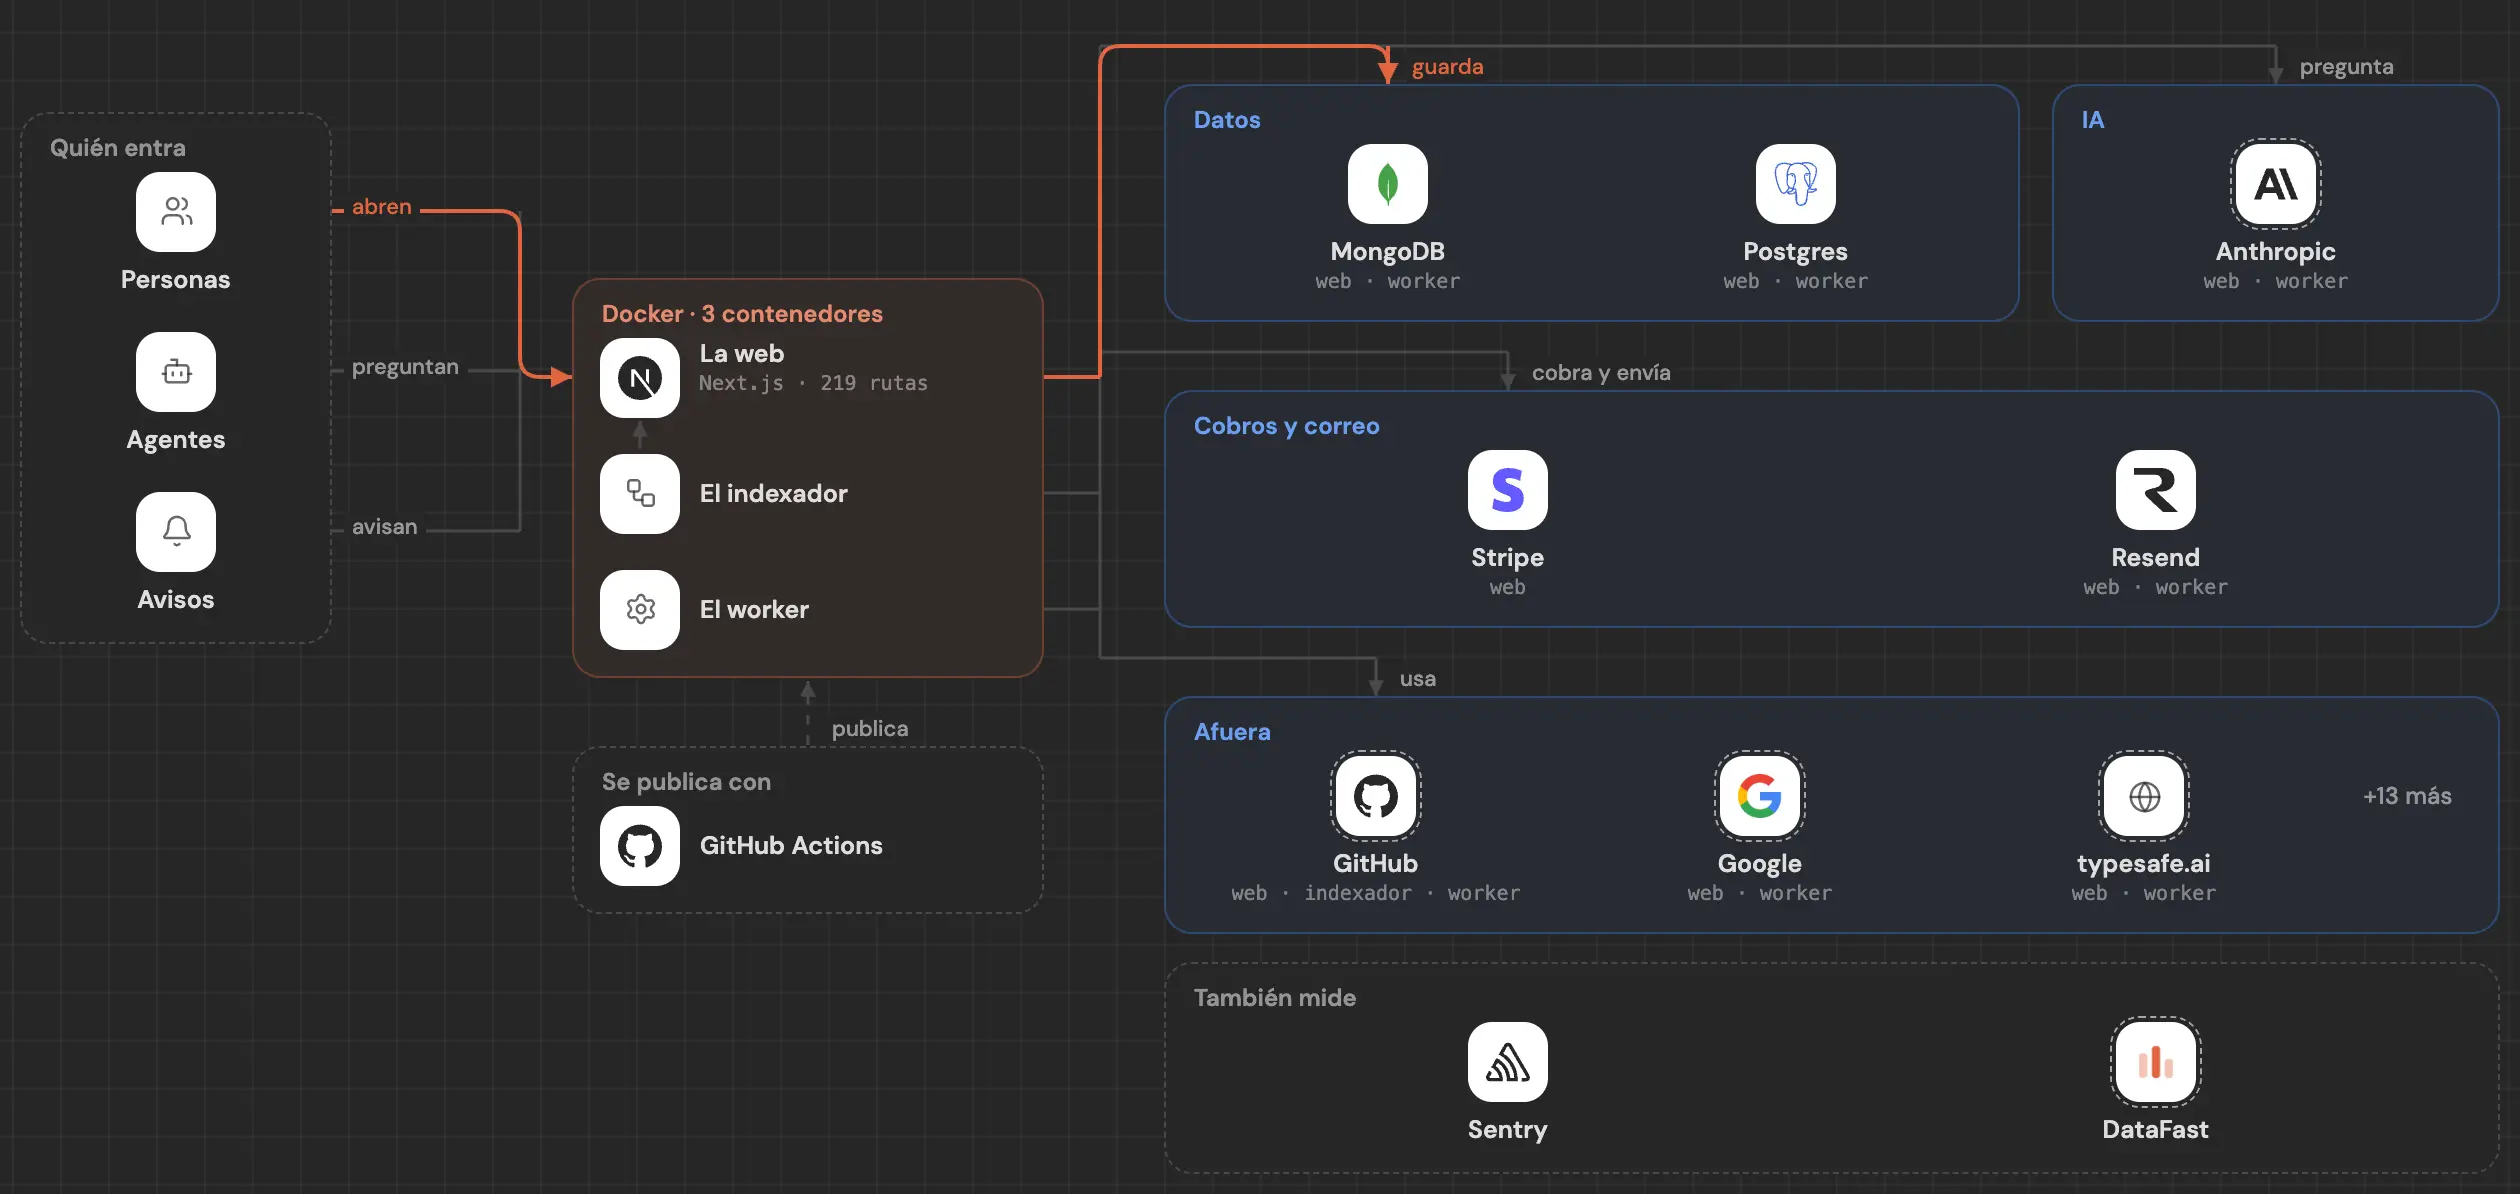
La ficha dice con qué está hecho. Su mapa entero lo abre por dentro: cada parte del código y cómo se conecta con las demás.
Frontend
Estilos 1
- google_fonts2 archivos
Interfaz 10
- xyflow4 archivos
@lumino/widgets2 archivos
@jupyterlab/mainmenu1 archivo
@monaco-editor/react1 archivo
dagre1 archivo
react-split1 archivo
- flutter_code_editor8 archivos
- highlight4 archivos
- fluttertoast1 archivo
- visibility_detector1 archivo
La base 2
- React16 archivos
- Jupyter
Backend
La base 1
Datos 56
- MongoDB10 archivos · sdks/python/apache_beam/io/mongodbio.py, línea 96
- DataStax8 archivos
pyarrow7 archivos
- org.apache.commons:commons-pool26 archivos
- NATS.io4 archivos
- SQLite3 archivos · sdks/java/core/src/main/java/org/apache/beam/sdk/util/SerializableUtils.java, línea 37
- MySQL2 archivos · sdks/go.mod, línea 43
- Neo4j2 archivos
- RabbitMQ2 archivos
- Elasticsearch1 archivo
github.com/aws/aws-sdk-go-v2/feature/s3/manager1 archivo
- Postgres1 archivo · sdks/go.mod, línea 47
- ClickHouse
- go.mongodb.org/mongo-driver
- Hive
- org.apache.avro:avro57 archivos
- software.amazon.kinesis:amazon-kinesis-client13 archivos
- org.apache.parquet:parquet-hadoop10 archivos
- fastavro6 archivos
- jakarta.jms:jakarta.jms-api6 archivos
- com.azure:azure-storage-blob5 archivos
- org.apache.kudu:kudu-client4 archivos
- com.azure:azure-cosmos3 archivos
- org.apache.qpid:proton-j3 archivos
- org.apache.solr:solr-solrj3 archivos
- shared_preferences2 archivos
- com.microsoft.azure:azure-storage1 archivo
- github.com/xitongsys/parquet-go1 archivo
- github.com/xitongsys/parquet-go-source1 archivo
- io.confluent:kafka-schema-registry-client1 archivo
- org.apache.parquet:parquet-avro1 archivo
- avatica-core
- calcite-druid
- client-v2
- hadoop-common
- hbase-client
- iceberg-api
- iceberg-aws
- iceberg-core
- iceberg-data
- iceberg-gcp
- iceberg-hive-metastore
- iceberg-orc
- iceberg-parquet
- jedis
- kafka-avro-serializer
- kafka-clients
- mssql-jdbc
- ojdbc8
- orc-core
- pq
- pulsar-client-api
- pymongo
- sqlite-jdbc
- util-hadoop
Inicio de sesión 5
- com.azure:azure-identity2 archivos
- cryptography2 archivos
- golang.org/x/oauth22 archivos
- firebase_auth
- firebase_auth_platform_interface
IA 4
- TensorFlow5 archivos
tensorflow-transform3 archivos
tf-keras
- openai-java-core
Servicios 5
 Google158 archivos · sdks/java/io/google-cloud-platform/src/main/java/org/apache/beam/sdk/io/gcp/bigquery/BigQueryServices.java, línea 33
- Kafka61 archivos · sdks/java/io/kafka/src/main/java/org/apache/beam/sdk/io/kafka/KafkaRecord.java, línea 23
- Google Cloud Storage10 archivos · sdks/java/extensions/google-cloud-platform-core/src/main/java/org/apache/beam/sdk/extensions/gcp/util/GcsUtil.java, línea 25
- Firebase8 archivos · learning/tour-of-beam/frontend/lib/firebase_options.dart, línea 3
 OpenAI1 archivo · sdks/java/ml/inference/openai/src/main/java/org/apache/beam/sdk/ml/inference/openai/OpenAIModelHandler.java, línea 24
Apoyo
La base 7
- Apache424 archivos
- JetBrains
- javax.servlet:javax.servlet-api11 archivos
- org.eclipse.jetty:jetty-server1 archivo
- org.eclipse.jetty:jetty-servlet1 archivo
- flutter_web_plugins
Contenido 4
pillow2 archivos
- flutter_svg17 archivos
- org.apache.tika:tika-core2 archivos
- markdown1 archivo
Pruebas 20
- Pytest134 archivos
- github.com/google/go-cmp82 archivos
github.com/stretchr/testify7 archivos
- Testing Library6 archivos
github.com/testcontainers/testcontainers-go3 archivos
pytest-mock1 archivo
pytest-asyncio
- junit:junit2,214 archivos
- mock72 archivos
- org.testcontainers:testcontainers64 archivos
- flutter_test55 archivos
- org.awaitility:awaitility6 archivos
- com.zaxxer:HikariCP3 archivos
- go.uber.org/goleak3 archivos
- org.apache.pulsar:pulsar-client2 archivos
- clock1 archivo
- github.com/fsouza/fake-gcs-server1 archivo
- github.com/johannesboyne/gofakes31 archivo
- mockserver-client-java
Despliegue 8
- cloud.google.com/go/logging2 archivos
github.com/moby/moby/api1 archivo
- org.slf4j:slf4j-api622 archivos
- log4j-slf4j-impl
- slf4j-jdk14
Herramientas 17
- Shadow
- com.google.auto.value:auto-value-annotations663 archivos
- com.google.protobuf:protobuf-gradle-plugin93 archivos
- json_annotation16 archivos
- typing-extensions6 archivos
- packaging4 archivos
- github.com/spf13/cobra3 archivos
- github.com/aws/smithy-go1 archivo
- org.codehaus.janino:commons-compiler1 archivo
- commons-cli
- gradle-docker-compose-plugin
- gradle-errorprone-plugin
- grgit-gradle
- grpcio-tools
- maven-invoker
- spotless-plugin-gradle
Otras 76
- com.google.guava:guava41 archivos
- NumPy29 archivos
- Esoteric Software10 archivos
- org.apache.thrift:libthrift4 archivos
python-dateutil3 archivos
- Lodash2 archivos
- tqdm2 archivos
- Avast1 archivo
- Flutter1 archivo
github.com/improbable-eng/grpc-web1 archivo
github.com/spf13/viper1 archivo
proto-plus
pyyaml
- Scala
wazero
- joda-time:joda-time720 archivos
- com.fasterxml.jackson.core:jackson-databind87 archivos
- com.fasterxml.jackson.core:jackson-core52 archivos
- easy_localization49 archivos
- google.golang.org/protobuf49 archivos
- get_it36 archivos
- grpcio24 archivos
- org.apache.commons:commons-lang324 archivos
- provider20 archivos
- com.google.http-client:google-http-client-gson18 archivos
- equatable15 archivos
- golang.org/x/exp11 archivos
- url_launcher10 archivos
- collection8 archivos
- requests8 archivos
- org.apache.httpcomponents:httpclient7 archivos
- pytz7 archivos
- com.azure:azure-core5 archivos
- dill5 archivos
- golang.org/x/net3 archivos
- golang.org/x/sync3 archivos
- gopkg.in/yaml.v33 archivos
- grpc3 archivos
- meta3 archivos
- sortedcontainers3 archivos
- com.clearspring.analytics:stream2 archivos
- connectivity_plus2 archivos
- github.com/dustin/go-humanize2 archivos
- github.com/linkedin/goavro/v22 archivos
- golang.org/x/text2 archivos
- google-crc32c2 archivos
- intl2 archivos
- com.tdunning:t-digest1 archivo
- fasteners1 archivo
- github.com/rs/cors1 archivo
- golang.org/x/sys1 archivo
- gopkg.in/yaml.v21 archivo
- http1 archivo
- httplib21 archivo
- jline:jline1 archivo
- jsonpickle1 archivo
- org.bouncycastle:bcprov-jdk15on1 archivo
- org.codehaus.janino:janino1 archivo
- org.conscrypt:conscrypt-openjdk-uber1 archivo
- org.objenesis:objenesis1 archivo
- org.reactivestreams:reactive-streams1 archivo
- rxdart1 archivo
- yaml1 archivo
- zstandard1 archivo
- ,
- calcite-core
- commons-lang
- hadoop-yarn-server-resourcemanager
- httpasyncclient
- httpcore
- httpcore-nio
- json-smart
- okhttp
- protobuf
- reactor-core
- t
Otros repos con un stack parecido
Ordenados por cuánto de su stack comparten con beam, y después por estrellas.
- infiniflowragflow94.1 k
RAGFlow is an agent-native database: a Retrieval-Augmented Generation (RAG) engine that grew into context infrastructure.
14 de 218 en común · GoComparar → - apachesuperset75.5 k
Apache Superset is a Data Visualization and Data Exploration Platform
13 de 218 en común · PythonComparar → - apacheairflow47.5 k
Apache Airflow - A platform to programmatically author, schedule, and monitor workflows
12 de 218 en común · PythonComparar → - open-webuiopen-webui158.8 k
User-friendly AI Interface (Supports Ollama, OpenAI API, ...)
11 de 218 en común · SvelteComparar → - usememosmemos64.4 k
Memos is an open-source, self-hosted note-taking app that brings your everyday thoughts together in a personal timeline. Your data stays yours, and you choose what to keep private or share.
11 de 218 en común · GoComparar → - mudlerLocalAI50.3 k
LocalAI is the open-source AI engine. Run any model - LLMs, vision, voice, image, video - on any hardware. No GPU required.
11 de 218 en común · GoComparar →
Preguntas frecuentes
¿En qué lenguaje está escrito beam?
¿Qué framework usa beam?
¿Qué base de datos usa beam?
La prueba: sdks/python/apache_beam/io/mongodbio.py, línea 96
¿Con qué inicia sesión beam?
¿beam usa IA?
¿Qué servicios usa beam?
¿beam tiene pruebas?
¿Qué repos tienen un stack parecido a beam?
Mira tu código por dentro, hoy.
Pega tu repo y lo ves dibujado, parte por parte: uno mediano, en menos de un minuto.
Gratis y sin cuenta.¿Repo privado? Entra con GitHub


