¿Con qué está hecho flink?
flink es un repo de Java hecho con grpc-bom, org.jetbrains.kotlin:kotlin-stdlib, apache-beam y Angular. Guarda sus datos en org.apache.avro:avro, Apache, org.apache.orc:orc-core, org.apache.parquet:parquet-hadoop, pyarrow y 5 más, inicia sesión con aws-java-sdk-sts, software.amazon.awssdk:sts y org.apache.hadoop:hadoop-minikdc, usa IA con OpenAI, se prueba con archunit-junit5, hadoop-minicluster, hamcrest-all, junit-jupiter-api, junit-jupiter-engine y 20 más, se despliega con commons-logging, hadoop-yarn-common, io.opentelemetry:opentelemetry-exporter-logging, kubernetes-httpclient-okhttp, log4j-layout-template-json y 11 más y usa apache-client, aws-crt-client, aws-java-sdk-dynamodb, aws-java-sdk-s3, fastavro y 12 más. Son 2,869,317 líneas escritas, con 5,728 archivos de prueba.
 LinkedIn
Leído el 8 de noviembre de 2026, en el commit 4fb928e. Léela en markdown
Frontend
Backend
Datos 27
- Apache40 archivos
pyarrow11 archivos
- InfluxDB3 archivos
- Hive
- org.apache.hadoop:hadoop-hdfs-client
- org.apache.avro:avro42 archivos
- org.apache.orc:orc-core27 archivos
- org.apache.parquet:parquet-hadoop11 archivos
- com.aliyun.oss:aliyun-sdk-oss5 archivos
- org.apache.hadoop:hadoop-hdfs3 archivos
- io.confluent:kafka-schema-registry-client2 archivos
- org.apache.parquet:parquet-avro2 archivos
- com.facebook.presto:presto-hive1 archivo
- apache-client
- aws-crt-client
- aws-java-sdk-dynamodb
- aws-java-sdk-s3
- fastavro
- hadoop-aliyun
- hadoop-apache2
- hadoop-aws
- hadoop-azure
- hadoop-common
- hadoop-mapreduce-client-core
- s3
- s3-transfer-manager
- zookeeper
Inicio de sesión 3
- software.amazon.awssdk:sts4 archivos
- org.apache.hadoop:hadoop-minikdc1 archivo
- aws-java-sdk-sts
Apoyo
La base 3
- apache-beam14 archivos
- org.jetbrains.kotlin:kotlin-stdlib
- grpc-bom
Pruebas 25
- org.assertj:assertj-core3,113 archivos
- org.junit.jupiter:junit-jupiter288 archivos
- org.mockito:mockito-core139 archivos
- org.junit:junit-bom125 archivos
- org.hamcrest:hamcrest-core63 archivos
- com.tngtech.archunit:archunit40 archivos
- org.testcontainers:testcontainers16 archivos
- org.apache.curator:curator-test8 archivos
- com.github.tomakehurst:wiremock-jre81 archivo
- io.airlift.tpch:tpch1 archivo
- junit:junit1 archivo
- net.javacrumbs.json-unit:json-unit-assertj1 archivo
- archunit-junit5
- hadoop-minicluster
- hamcrest-all
- junit-jupiter-api
- junit-jupiter-engine
- junit-vintage-engine
- kubernetes-server-mock
- mockito-junit-jupiter
- mockito-subclass
- mockwebserver
- scalatest_${scala.binary.version}
- testcontainers-bom
- testcontainers-junit-jupiter
Despliegue 16
- OpenTelemetry5 archivos
- io.opentelemetry:opentelemetry-api4 archivos
- org.apache.logging.log4j:log4j-api4 archivos
- io.opentelemetry:opentelemetry-exporter-otlp3 archivos
- io.opentelemetry:opentelemetry-exporter-logging
- org.apache.logging.log4j:log4j-slf4j2-impl
- Prometheus
- org.slf4j:slf4j-api950 archivos
- io.fabric8:kubernetes-client12 archivos
- org.apache.logging.log4j:log4j-core4 archivos
- commons-logging
- hadoop-yarn-common
- kubernetes-httpclient-okhttp
- log4j-layout-template-json
- metrics-core
- metrics-graphite
Herramientas 10
- org.immutables:value79 archivos
- org.checkerframework:checker-qual57 archivos
- org.antlr:antlr4-runtime9 archivos
- org.projectlombok:lombok2 archivos
- typing-extensions2 archivos
- org.codehaus.janino:commons-compiler1 archivo
- async-profiler
- checkstyle
- commons-cli
- jsr305
Otras 67
- Esoteric Software22 archivos
- pandas8 archivos
- org.apache.commons:commons-text6 archivos
ruamel.yaml2 archivos
- io.opentelemetry:opentelemetry-context1 archivo
- NumPy1 archivo
python-dateutil1 archivo
- JetBrains
- Scala
- org.apache.calcite:calcite-core368 archivos
- org.apache.hadoop:hadoop-yarn-api137 archivos
- org.apache.commons:commons-lang361 archivos
- py4j29 archivos
- com.amazonaws:aws-java-sdk-core12 archivos
- org.apache.hadoop:hadoop-yarn-client12 archivos
- org.jline:jline-terminal11 archivos
- org.apache.commons:commons-math310 archivos
- org.apache.commons:commons-compress7 archivos
- com.typesafe:config6 archivos
- org.objenesis:objenesis5 archivos
- cloudpickle4 archivos
- io.airlift:aircompressor4 archivos
- org.jline:jline-reader4 archivos
- pytz4 archivos
- org.reflections:reflections3 archivos
- com.fasterxml.jackson:jackson-bom2 archivos
- org.codehaus.janino:janino2 archivos
- com.fasterxml.jackson.core:jackson-core1 archivo
- com.ibm.icu:icu4j1 archivo
- com.knuddels:jtokkit1 archivo
- org.roaringbitmap:RoaringBitmap1 archivo
- org.snakeyaml:snakeyaml-engine1 archivo
- org.xerial.snappy:snappy-java1 archivo
- arrow-memory-netty
- aws-crt
- byte-buddy
- byte-buddy-agent
- commons-codec
- commons-collections
- commons-configuration
- commons-io
- conscrypt-openjdk-uber
- fastutil
- httpclient
- httpcore
- httplib2
- jackson-annotations
- jackson-databind
- jackson-datatype-jdk8
- jackson-mapper-asl
- javassist
- jna
- joda-time
- json-path
- logging-interceptor
- lz4-java
- netty-bom
- netty-handler
- netty-nio-client
- netty-transport
- okhttp
- oshi-core
- protobuf
- quartz
- requests
- zstd-jni
Otros repos con un stack parecido
Ordenados por cuánto de su stack comparten con flink, y después por estrellas.
- apacheairflow47.4 k
Apache Airflow - A platform to programmatically author, schedule, and monitor workflows
 6 de 153 en común · PythonComparar →
- mudlerLocalAI50.2 k
LocalAI is the open-source AI engine. Run any model - LLMs, vision, voice, image, video - on any hardware. No GPU required.
5 de 153 en común · GoComparar → - seaweedfsseaweedfs35.9 k
SeaweedFS is a distributed storage system for object storage (S3), file systems, Iceberg table buckets, and Lance vector buckets, designed to handle billions of files with O(1) disk access and effortless horizontal scaling.
5 de 153 en común · GoComparar → - nrwlnx29.5 k
The Monorepo Platform that amplifies both developers and AI agents. Nx optimizes your builds, scales your CI, and fixes failed PRs automatically. Ship in half the time.
5 de 153 en común · TypeScriptComparar → - appsmithorgappsmith41.2 k
Platform to build admin panels, internal tools, and dashboards. Integrates with 25+ databases and any API.
4 de 153 en común · TypeScriptComparar → - YunaiVruoyi-vue-pro40.3 k
🔥 官方推荐 🔥 RuoYi-Vue 全新 Pro 版本,优化重构所有功能。基于 Spring Boot + MyBatis Plus + Vue & Element 实现的后台管理系统 + 微信小程序,支持 RBAC 动态权限、数据权限、SaaS 多租户、Flowable 工作流、三方登录、支付、短信、商城、CRM、ERP、MES、IM、AI 大模型、IoT 物联网等功能。你的 ⭐️ Star ⭐️,是作者生发的动力!
4 de 153 en comúnComparar →
Preguntas frecuentes
¿En qué lenguaje está escrito flink?
¿Qué framework usa flink?
¿Qué base de datos usa flink?
¿Con qué inicia sesión flink?
¿flink usa IA?
¿Qué servicios usa flink?
¿flink tiene pruebas?
¿Qué repos tienen un stack parecido a flink?
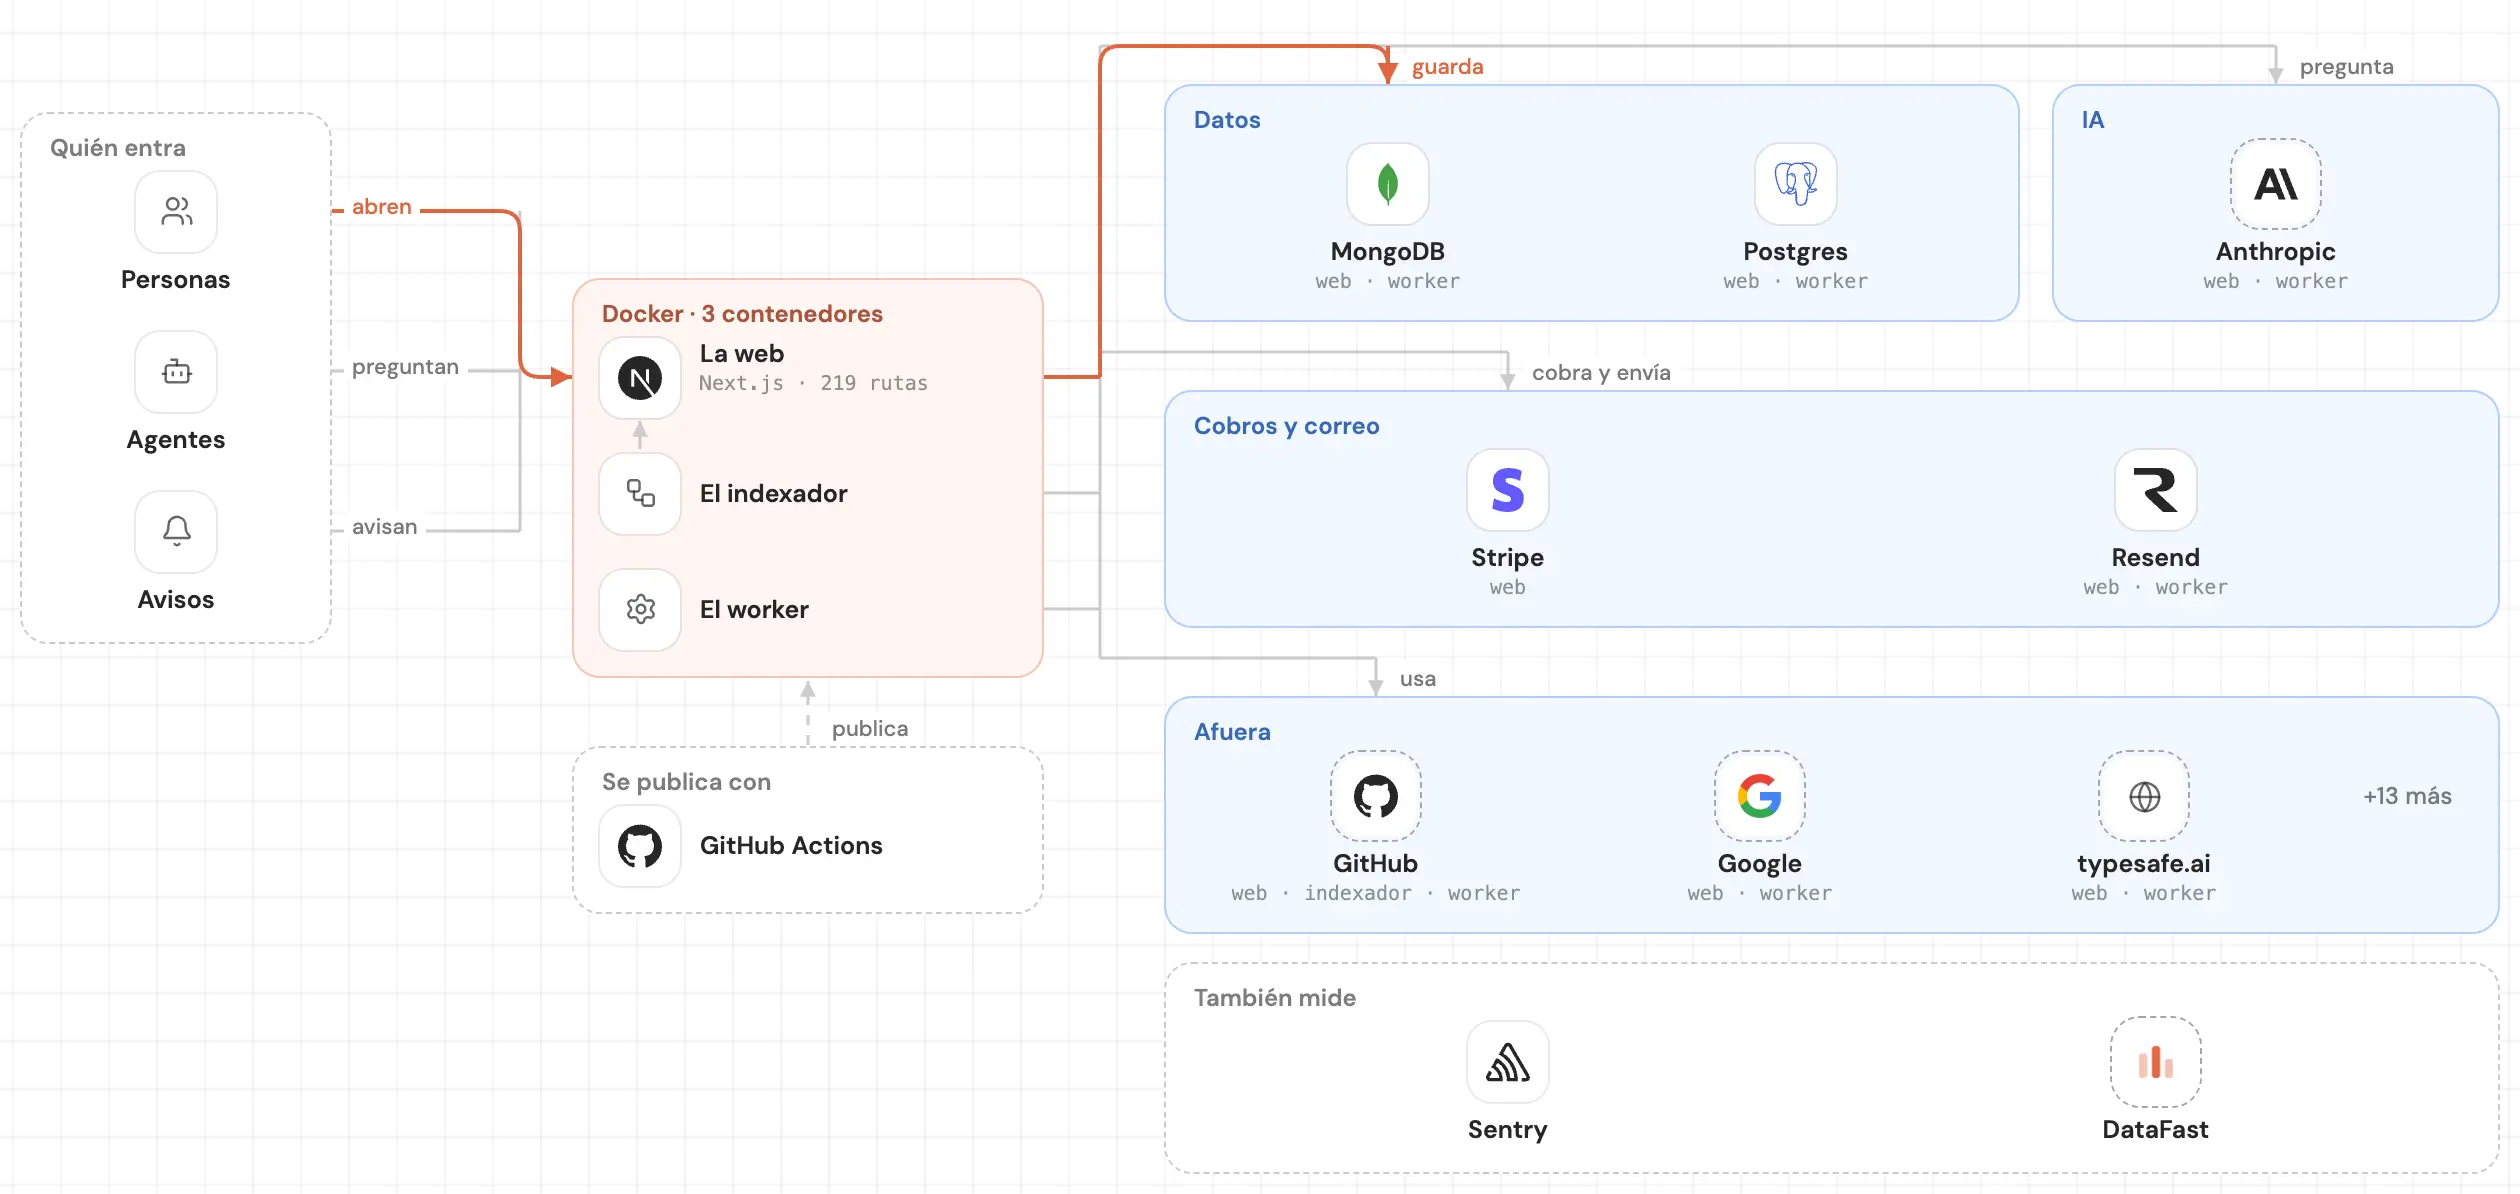
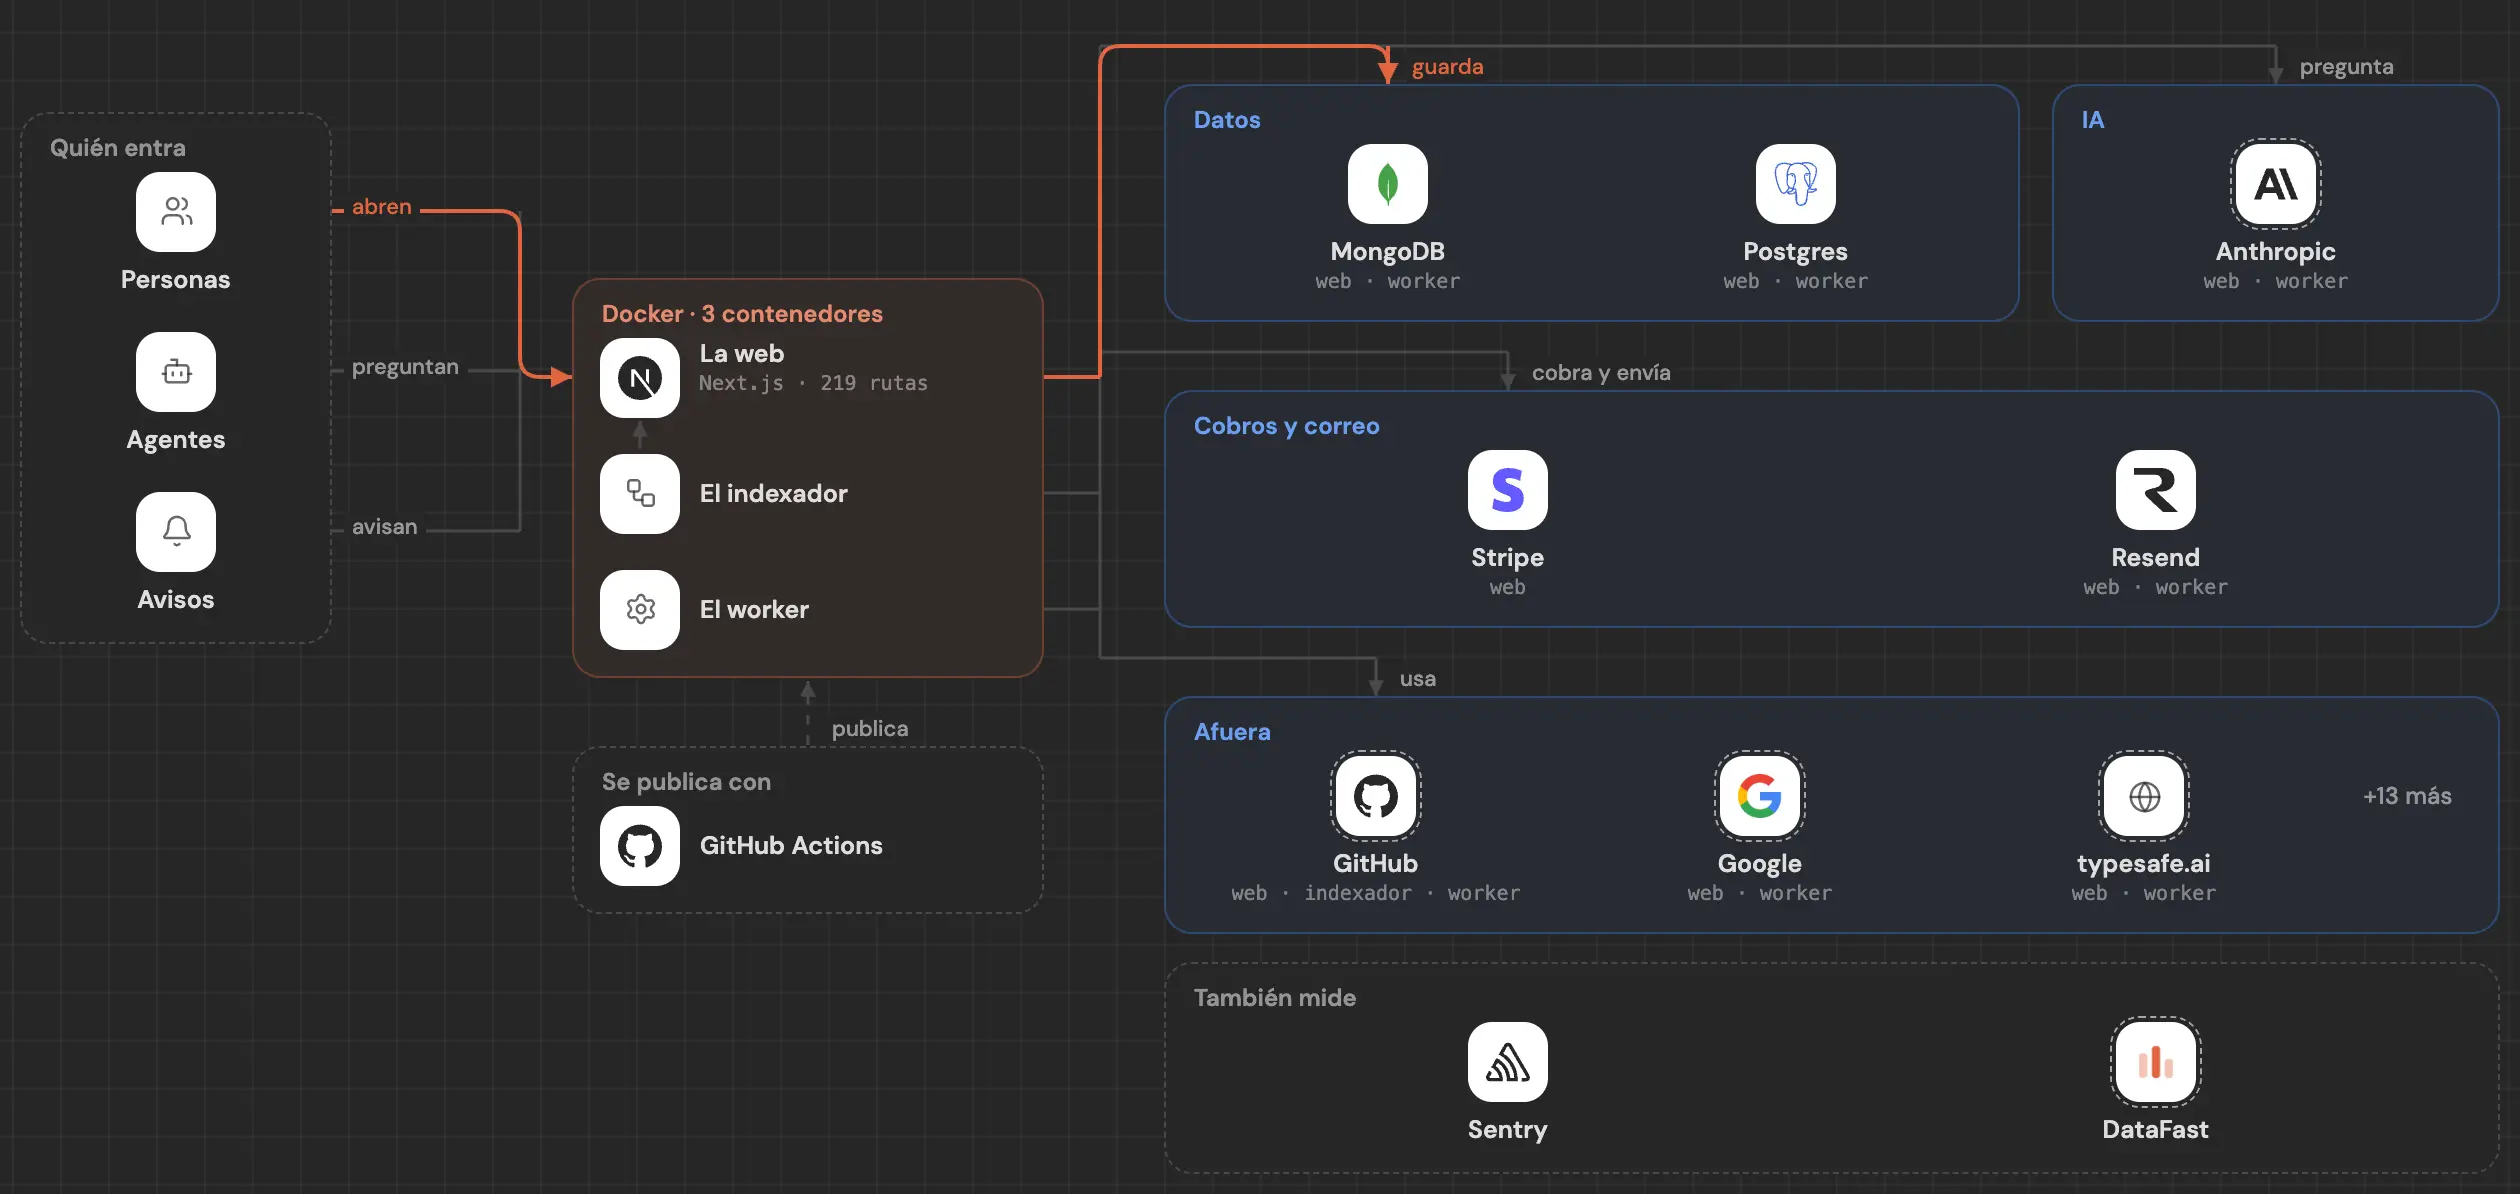
Mira tu código por dentro, hoy.
Pega tu repo y lo ves dibujado, parte por parte: uno mediano, en menos de un minuto.
Gratis y sin cuenta.


