¿Con qué está hecho hadoop?
hadoop es un repo de Java hecho con JAX-RS, jakarta.servlet-api, jakarta.ws.rs-api, jersey-common, jersey-container-servlet y 9 más. Guarda sus datos en software.amazon.awssdk:bundle, org.apache.avro:avro, org.apache.zookeeper:zookeeper, org.apache.curator:curator-framework, com.aliyun.oss:aliyun-sdk-oss y 2 más, accede a ellos con ember-data, inicia sesión con apacheds-core, hadoop-auth, kerb-simplekdc, org.apache.kerby:kerb-core y com.nimbusds:nimbus-jose-jwt, arma su contenido con jdom2, xercesImpl y org.apache.commons:commons-csv, valida sus datos con Zod y @hookform/resolvers, se prueba con junit-jupiter-engine, junit-platform-launcher, mockito-all, mockito-inline, mockserver-netty y 11 más, se despliega con commons-logging, hadoop-yarn-common, jul-to-slf4j, log4j-1.2-api, log4j-core y 9 más y usa curator-client, curator-recipes, hadoop-aws, hadoop-azure, hadoop-client y 18 más. Son 3,097,660 líneas escritas, con 4,764 archivos de prueba.
 LinkedIn
Leído el 7 de noviembre de 2026, en el commit 1fdf777. Léela en markdown
Frontend
La base 2
Estilos 3
class-variance-authority6 archivos
tailwind-merge1 archivo
- Tailwind CSS
Interfaz 9
- Radix UI22 archivos
- React Hook Form7 archivos
sonner6 archivos
- xyflow4 archivos
dagre1 archivo
react-resizable-panels1 archivo
vaul1 archivo
- @atlaskit/pragmatic-drag-and-drop1 archivo
- cmdk1 archivo
Iconos 1
- Lucide49 archivos
Backend
La base 1
- JAX-RS108 archivos
Datos 28
- org.apache.arrow:arrow-vector1 archivo
- org.apache.hadoop:hadoop-hdfs-client
- software.amazon.awssdk:bundle107 archivos
- org.apache.avro:avro28 archivos
- org.apache.zookeeper:zookeeper25 archivos
- org.apache.curator:curator-framework16 archivos
- com.aliyun.oss:aliyun-sdk-oss9 archivos
- com.qcloud:cos_api-bundle9 archivos
- com.zaxxer:HikariCP6 archivos
- com.github.ben-manes.caffeine:caffeine1 archivo
- javax.cache:cache-api1 archivo
- org.ehcache:ehcache1 archivo
- org.hsqldb:hsqldb1 archivo
- curator-client
- curator-recipes
- hadoop-aws
- hadoop-azure
- hadoop-client
- hadoop-client-api
- hadoop-common
- hadoop-hdfs
- hadoop-mapreduce-client-common
- hadoop-mapreduce-client-core
- hbase-client
- hbase-common
- hbase-server
- kafka-clients
- mssql-jdbc
Inicio de sesión 5
- org.apache.kerby:kerb-core3 archivos
- com.nimbusds:nimbus-jose-jwt1 archivo
- apacheds-core
- hadoop-auth
- kerb-simplekdc
Servicios 2
Acceso a los datos 1
- ember-data96 archivos
Apoyo
La base 11
- JetBrains
- com.google.inject:guice80 archivos
- org.eclipse.jetty:jetty-server8 archivos
- org.eclipse.jetty:jetty-servlet7 archivos
- ember-resolver1 archivo
- jakarta.servlet-api
- jakarta.ws.rs-api
- jersey-common
- jersey-container-servlet
- jersey-media-json-jackson
- jersey-server
Contenido 3
- org.apache.commons:commons-csv2 archivos
- jdom2
- xercesImpl
Pruebas 16
- Vitest93 archivos
- Testing Library44 archivos
msw4 archivos
- org.junit.jupiter:junit-jupiter-api3,679 archivos
- org.mockito:mockito-core986 archivos
- org.assertj:assertj-core646 archivos
- org.junit.jupiter:junit-jupiter-params201 archivos
- org.apache.curator:curator-test24 archivos
- org.mockito:mockito-junit-jupiter18 archivos
- org.skyscreamer:jsonassert1 archivo
- junit-jupiter-engine
- junit-platform-launcher
- mockito-all
- mockito-inline
- mockserver-netty
- system-rules
Despliegue 14
- OpenTelemetry
- org.apache.logging.log4j:log4j-api
- org.slf4j:slf4j-api1,846 archivos
- commons-logging
- hadoop-yarn-common
- jcl-over-slf4j
- jul-to-slf4j
- log4j-1.2-api
- log4j-core
- log4j-slf4j-impl
- logback-classic
- metrics-core
- reload4j
- slf4j-reload4j
Herramientas 15
- Swagger20 archivos
- org.apache.maven:maven-plugin-api10 archivos
- @react-router/dev1 archivo
ember-cli1 archivo
- OpenJDK
- org.apache.ant:ant
- animal-sniffer-annotations
- asm
- asm-commons
- checkstyle
- commons-cli
- extra-enforcer-rules
- jsr305
- maven-plugin-annotations
- spotbugs
Validación 2
- Zod5 archivos
@hookform/resolvers3 archivos
Otras 82
- Apache26 archivos
zustand23 archivos
- Google14 archivos
- org.apache.commons:commons-configuration213 archivos
- com.google.re2j:re2j6 archivos
- Immer3 archivos
- com.google.protobuf:protobuf-java2 archivos
nanoid2 archivos
es-toolkit1 archivo
- jQuery1 archivo
- com.google.guava:guava
- org.apache.httpcomponents.client5:httpclient5
- ReactiveX
- org.apache.commons:commons-lang3360 archivos
- javax.annotation:javax.annotation-api143 archivos
- com.fasterxml.jackson.core:jackson-databind98 archivos
- com.fasterxml.jackson.core:jackson-core53 archivos
- org.apache.commons:commons-collections440 archivos
- org.glassfish:javax.json30 archivos
- io.netty:netty-handler18 archivos
- io.netty:netty-buffer17 archivos
- org.apache.httpcomponents:httpclient17 archivos
- org.codehaus.jettison:jettison11 archivos
- org.apache.commons:commons-math310 archivos
- net.jodah:failsafe6 archivos
- org.apache.commons:commons-compress6 archivos
- com.jcraft:jsch4 archivos
- com.fasterxml.jackson.module:jackson-module-jaxb-annotations3 archivos
- com.github.luben:zstd-jni2 archivos
- io.grpc:grpc-core2 archivos
- org.xerial.snappy:snappy-java2 archivos
- clsx1 archivo
- com.amazonaws:aws-java-sdk-core1 archivo
- io.grpc:grpc-netty1 archivo
- io.grpc:grpc-stub1 archivo
- org.eclipse.jetty.websocket:websocket-client1 archivo
- org.jline:jline1 archivo
- org.yaml:snakeyaml1 archivo
- arrow-memory-netty
- bcpkix-jdk18on
- bcprov-jdk18on
- byte-buddy
- byte-buddy-agent
- cglib
- commons-codec
- commons-io
- commons-net
- dnsjava
- fst
- ftpserver-core
- grpc-protobuf
- hadoop-shaded-guava
- hadoop-shaded-protobuf_3_25
- http2-client
- http2-http-client-transport
- httpasyncclient
- httpcore
- httpcore-nio
- httpcore5
- jackson-annotations
- jackson-dataformat-cbor
- jakarta.activation-api
- jakarta.json-api
- jakarta.xml.bind-api
- jaxb-runtime
- jna
- json-simple
- lz4-java
- mina-core
- netty-all
- netty-codec
- netty-codec-socks
- netty-common
- netty-handler-proxy
- netty-resolver
- netty-transport
- netty-transport-native-epoll
- netty-transport-native-unix-common
- objenesis
- plexus-utils
- wildfly-openssl
- woodstox-core
Otros repos con un stack parecido
Ordenados por cuánto de su stack comparten con hadoop, y después por estrellas.
- infiniflowragflow93.5 k
RAGFlow is an agent-native database: a Retrieval-Augmented Generation (RAG) engine that grew into context infrastructure.
15 de 195 en común · GoComparar → - supabasesupabase114.5 k
The Postgres development platform. Supabase gives you a dedicated Postgres database to build your web, mobile, and AI applications.
14 de 195 en común · TypeScriptComparar → - TryGhostGhost55.7 k
Independent technology for modern publishing, memberships, subscriptions and newsletters.
13 de 195 en común · TypeScriptComparar → - CherryHQcherry-studio53.3 k
Your AI workspace for models, agents, and productivity.
13 de 195 en común · TypeScriptComparar → - QuantumNousnew-api51.4 k
Open-source AI gateway. Self-hosted LLM gateway with OpenAI-, Claude- and Gemini-compatible APIs, model routing, access control, usage tracking and cost accounting.
13 de 195 en común · GoComparar → - novuhqnovu40.3 k
The open-source communication infrastructure for agents and products
13 de 195 en común · TypeScriptComparar →
Preguntas frecuentes
¿En qué lenguaje está escrito hadoop?
¿Qué framework usa hadoop?
¿Qué base de datos usa hadoop?
¿Con qué inicia sesión hadoop?
¿Qué servicios usa hadoop?
¿hadoop tiene pruebas?
¿Qué repos tienen un stack parecido a hadoop?
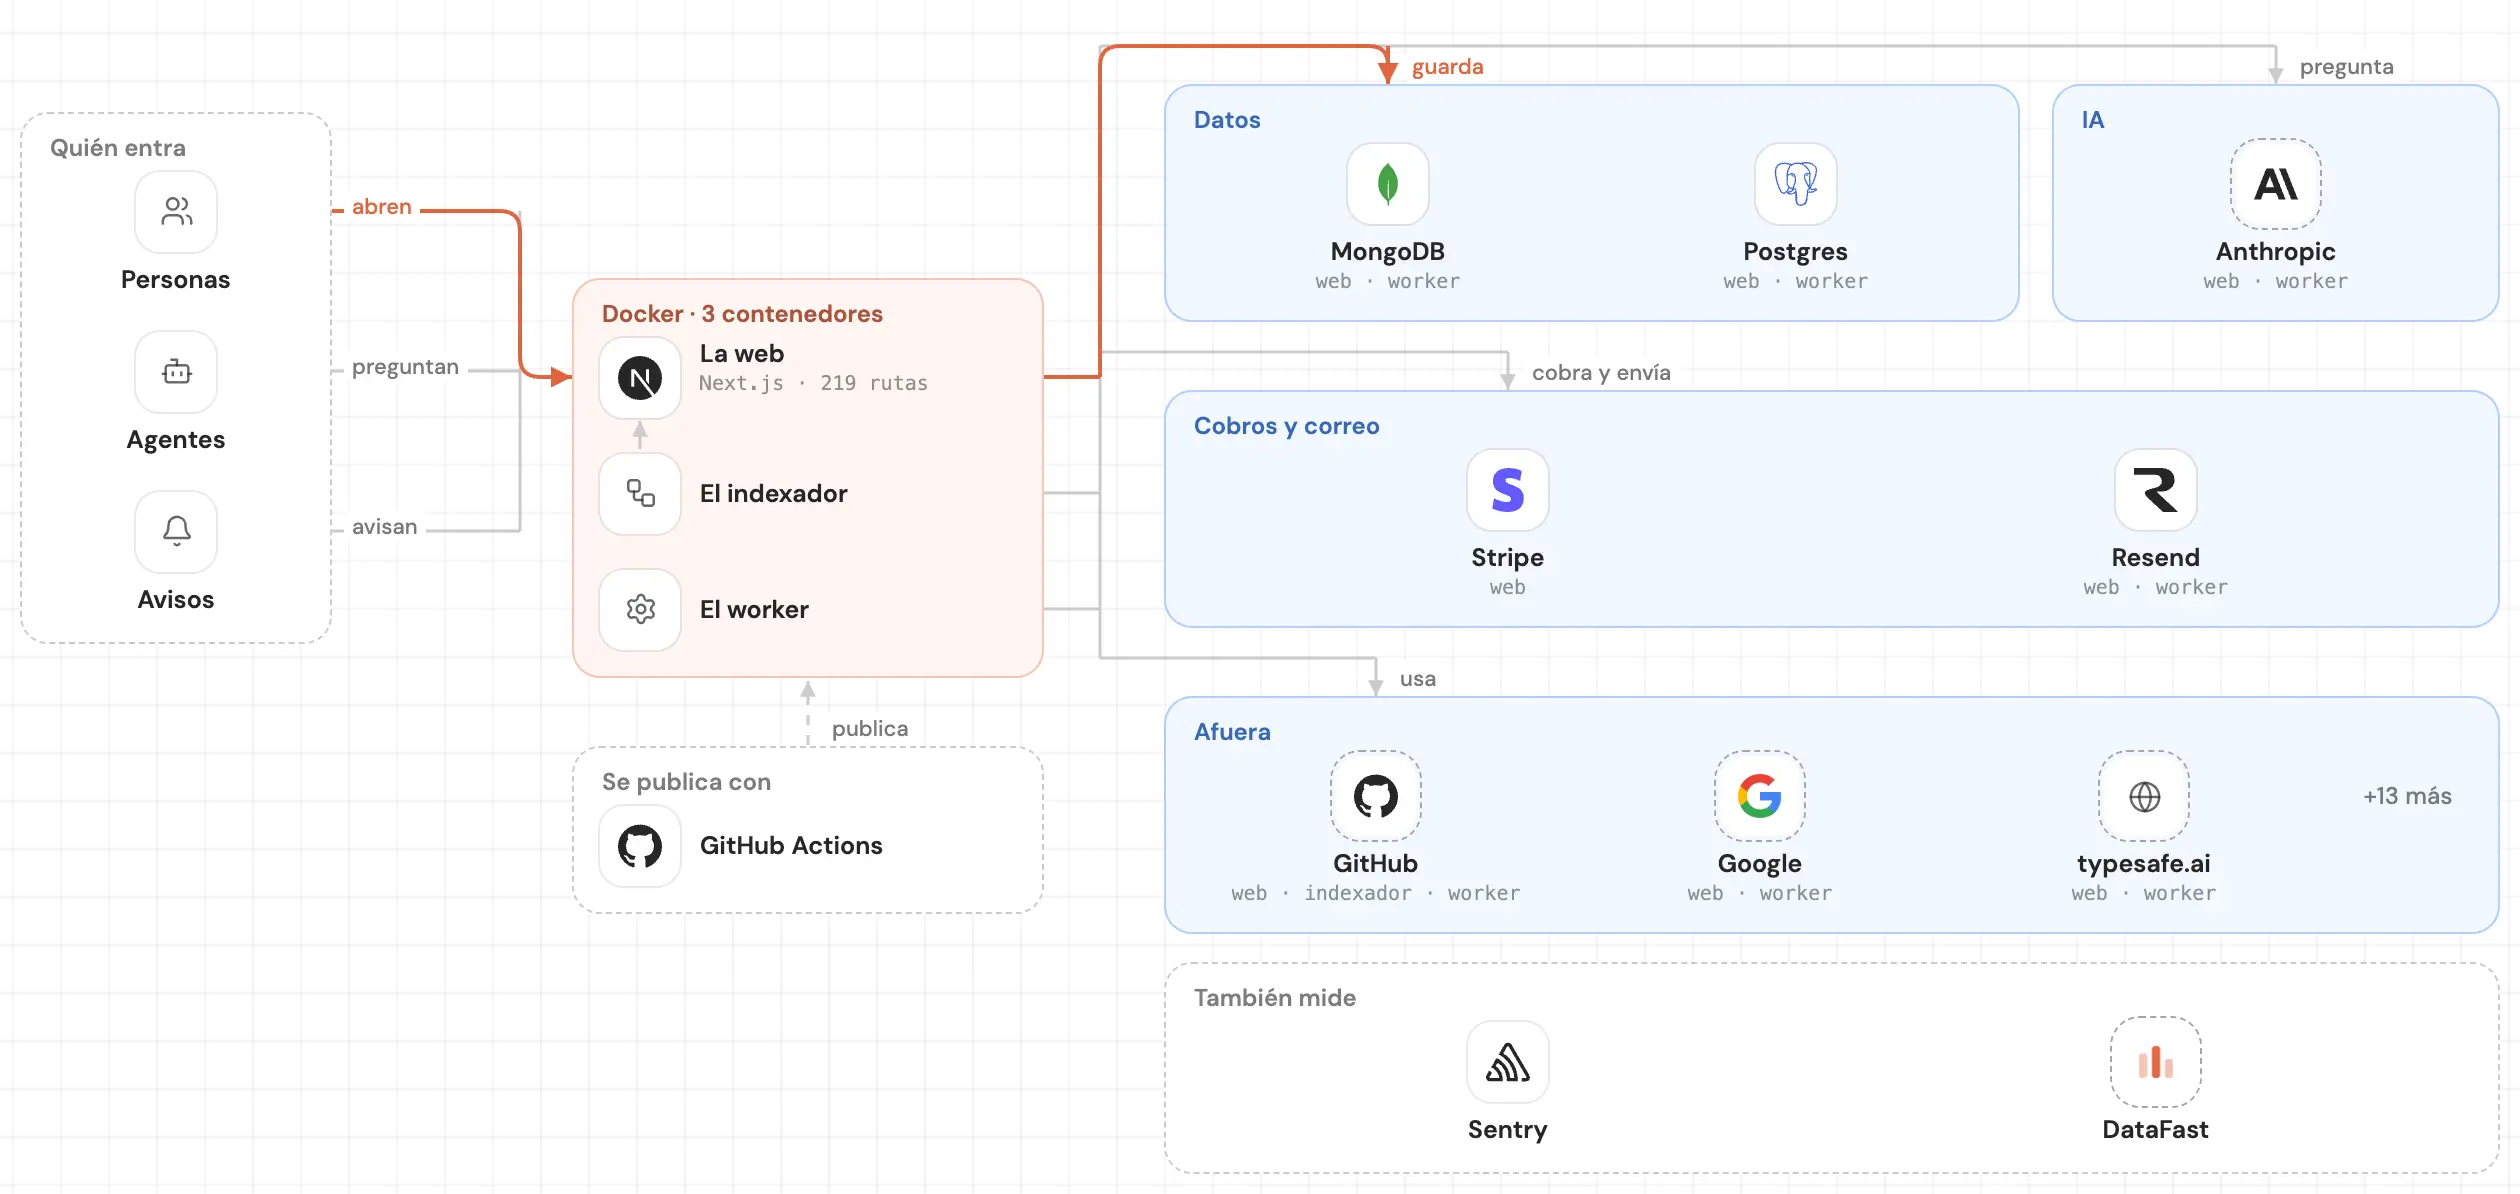
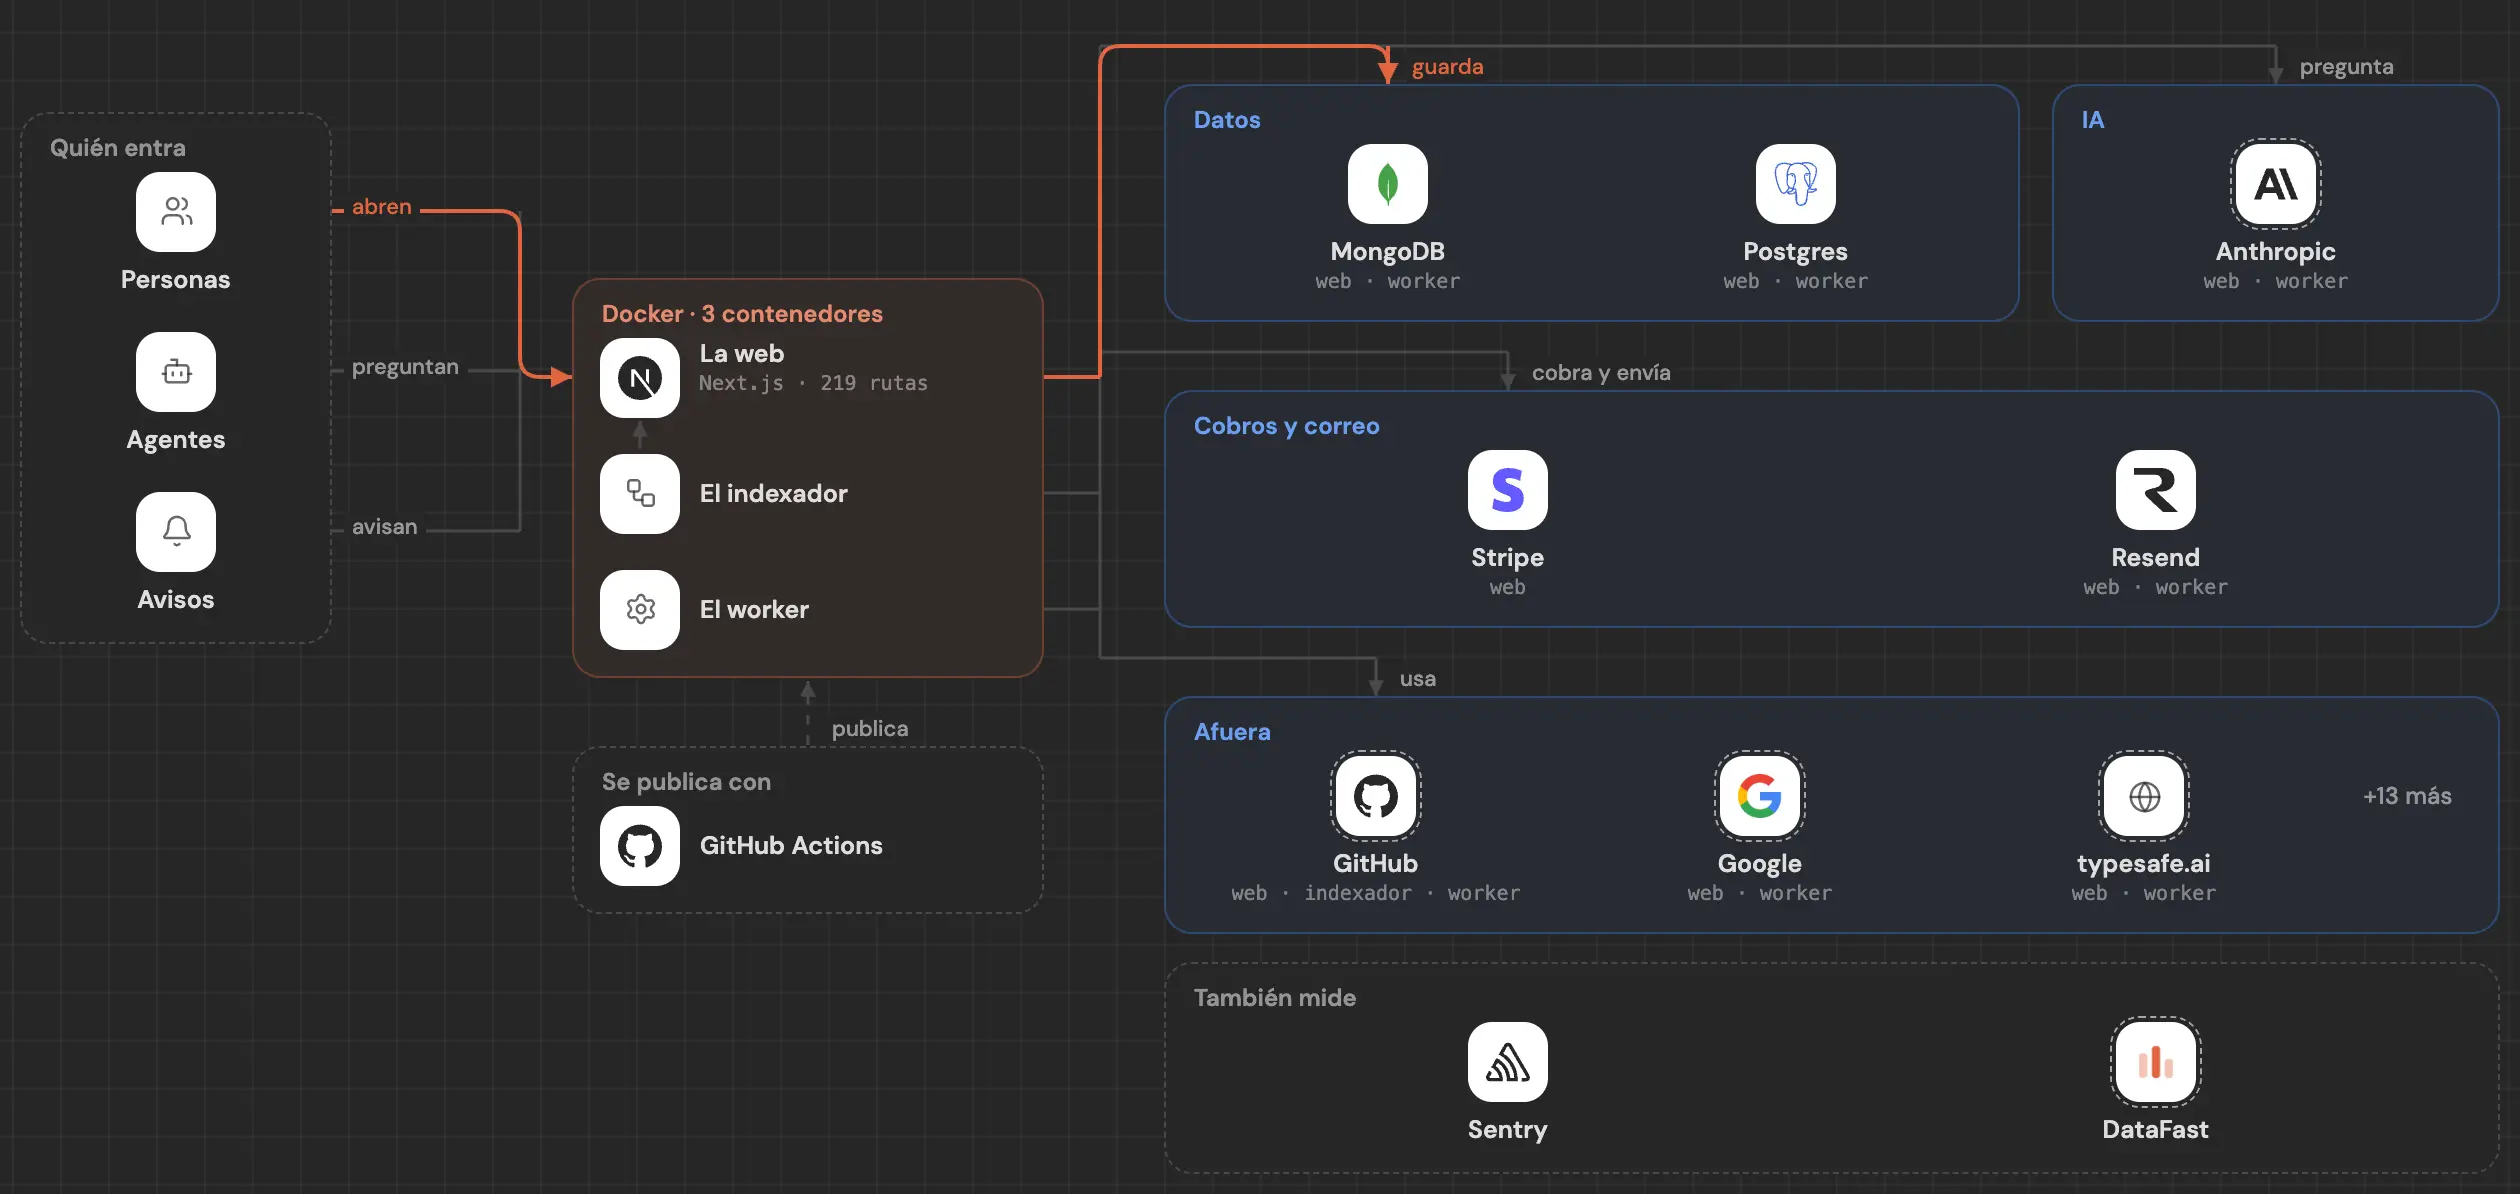
Mira tu código por dentro, hoy.
Pega tu repo y lo ves dibujado, parte por parte: uno mediano, en menos de un minuto.
Gratis y sin cuenta.


