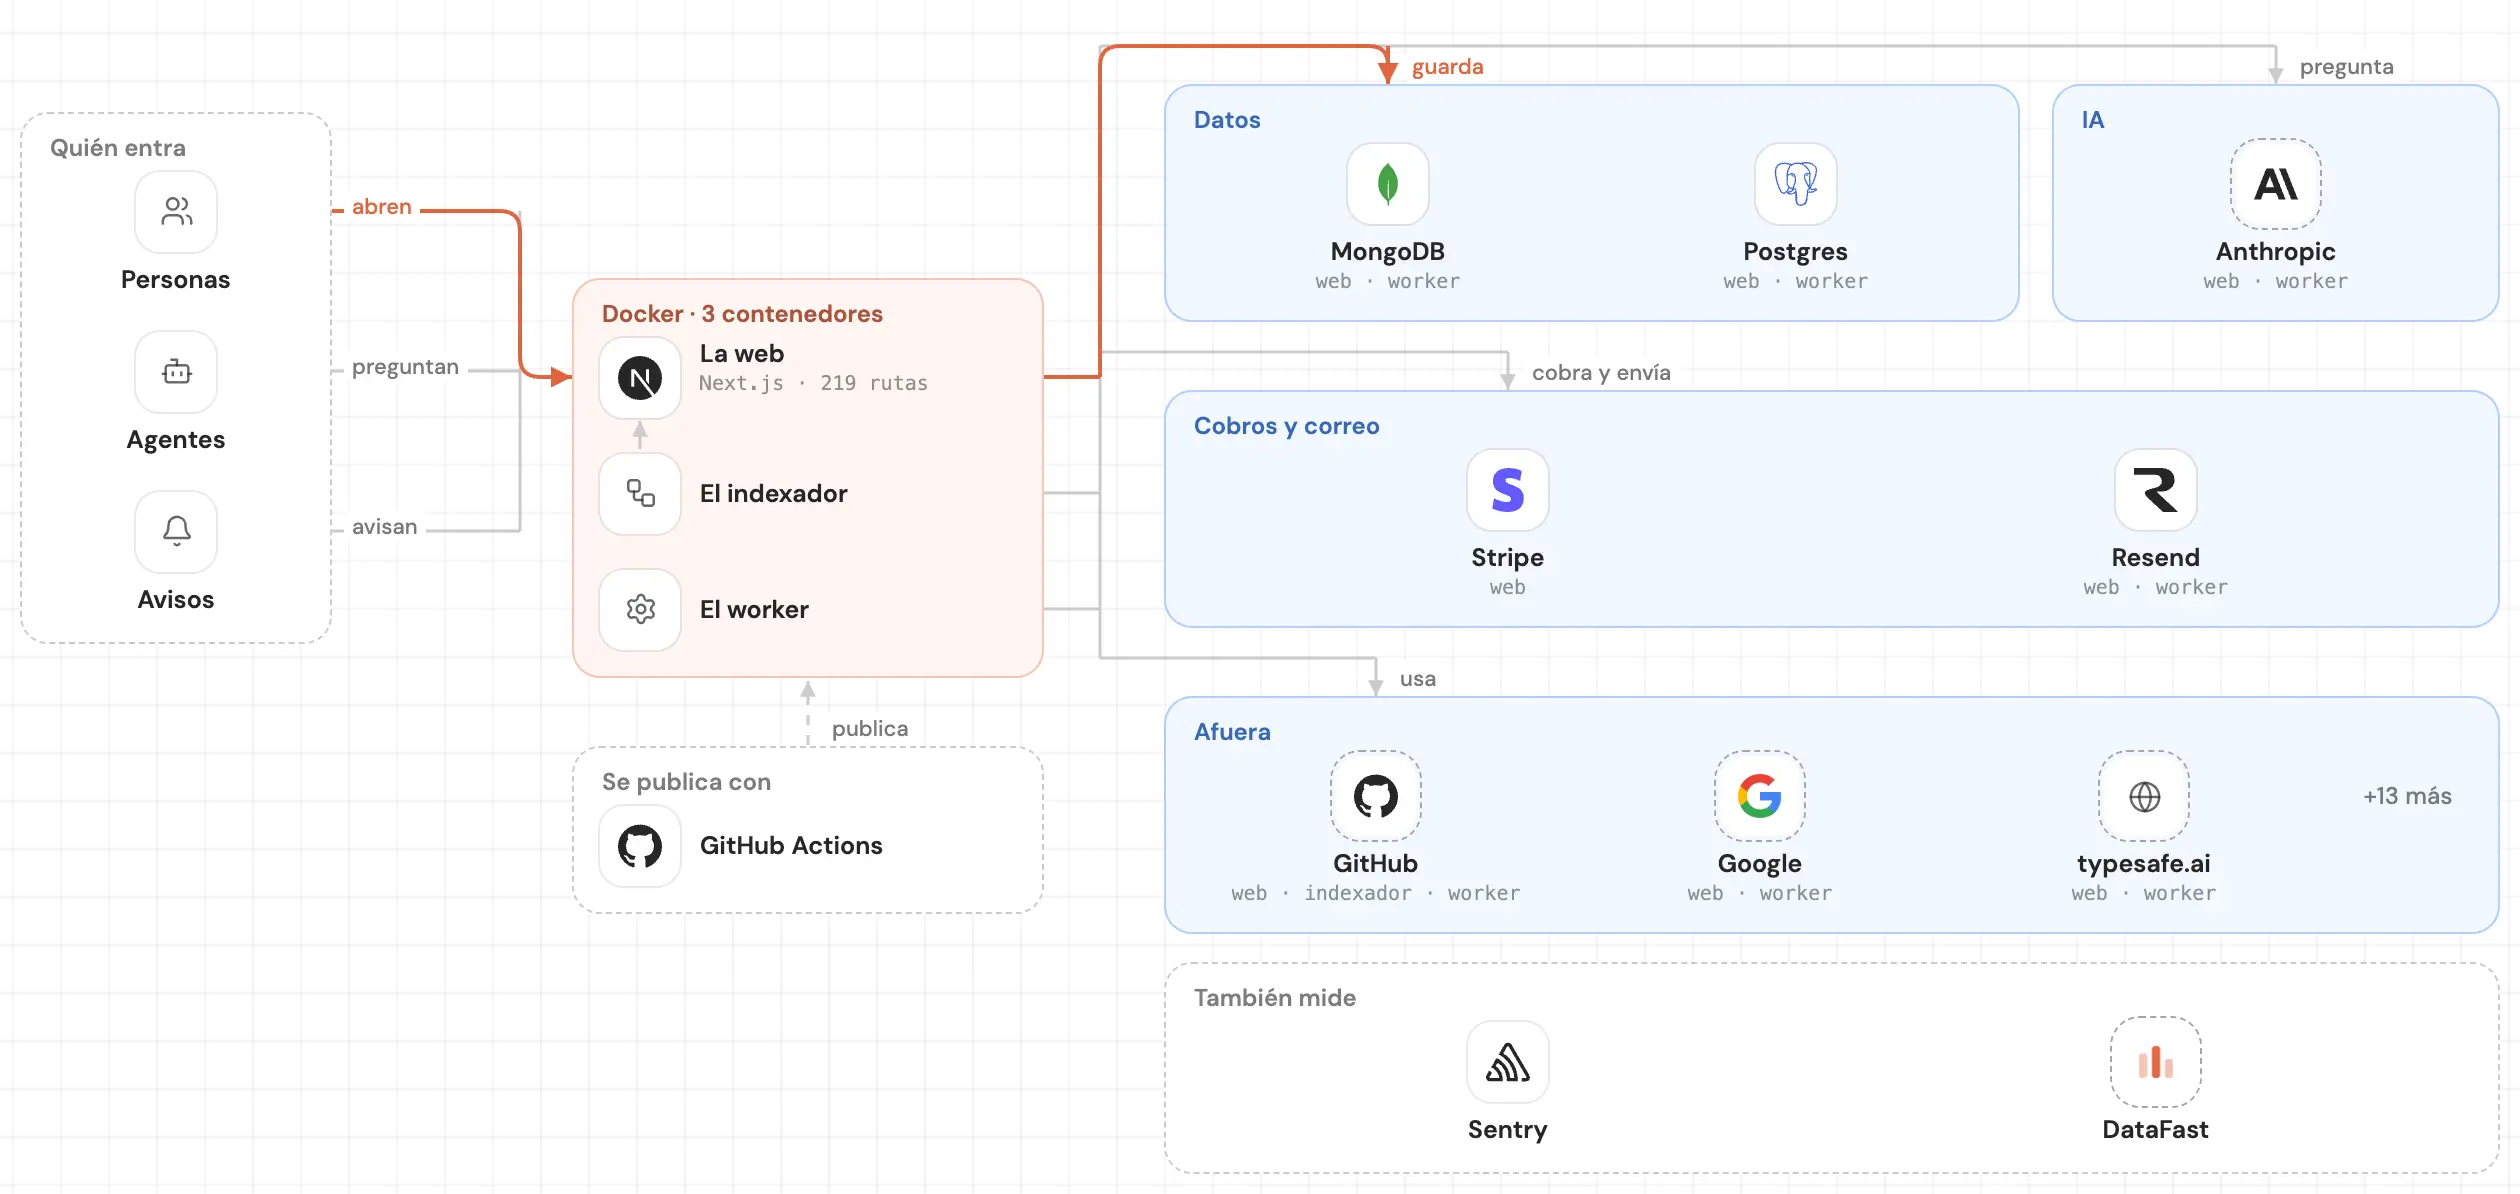
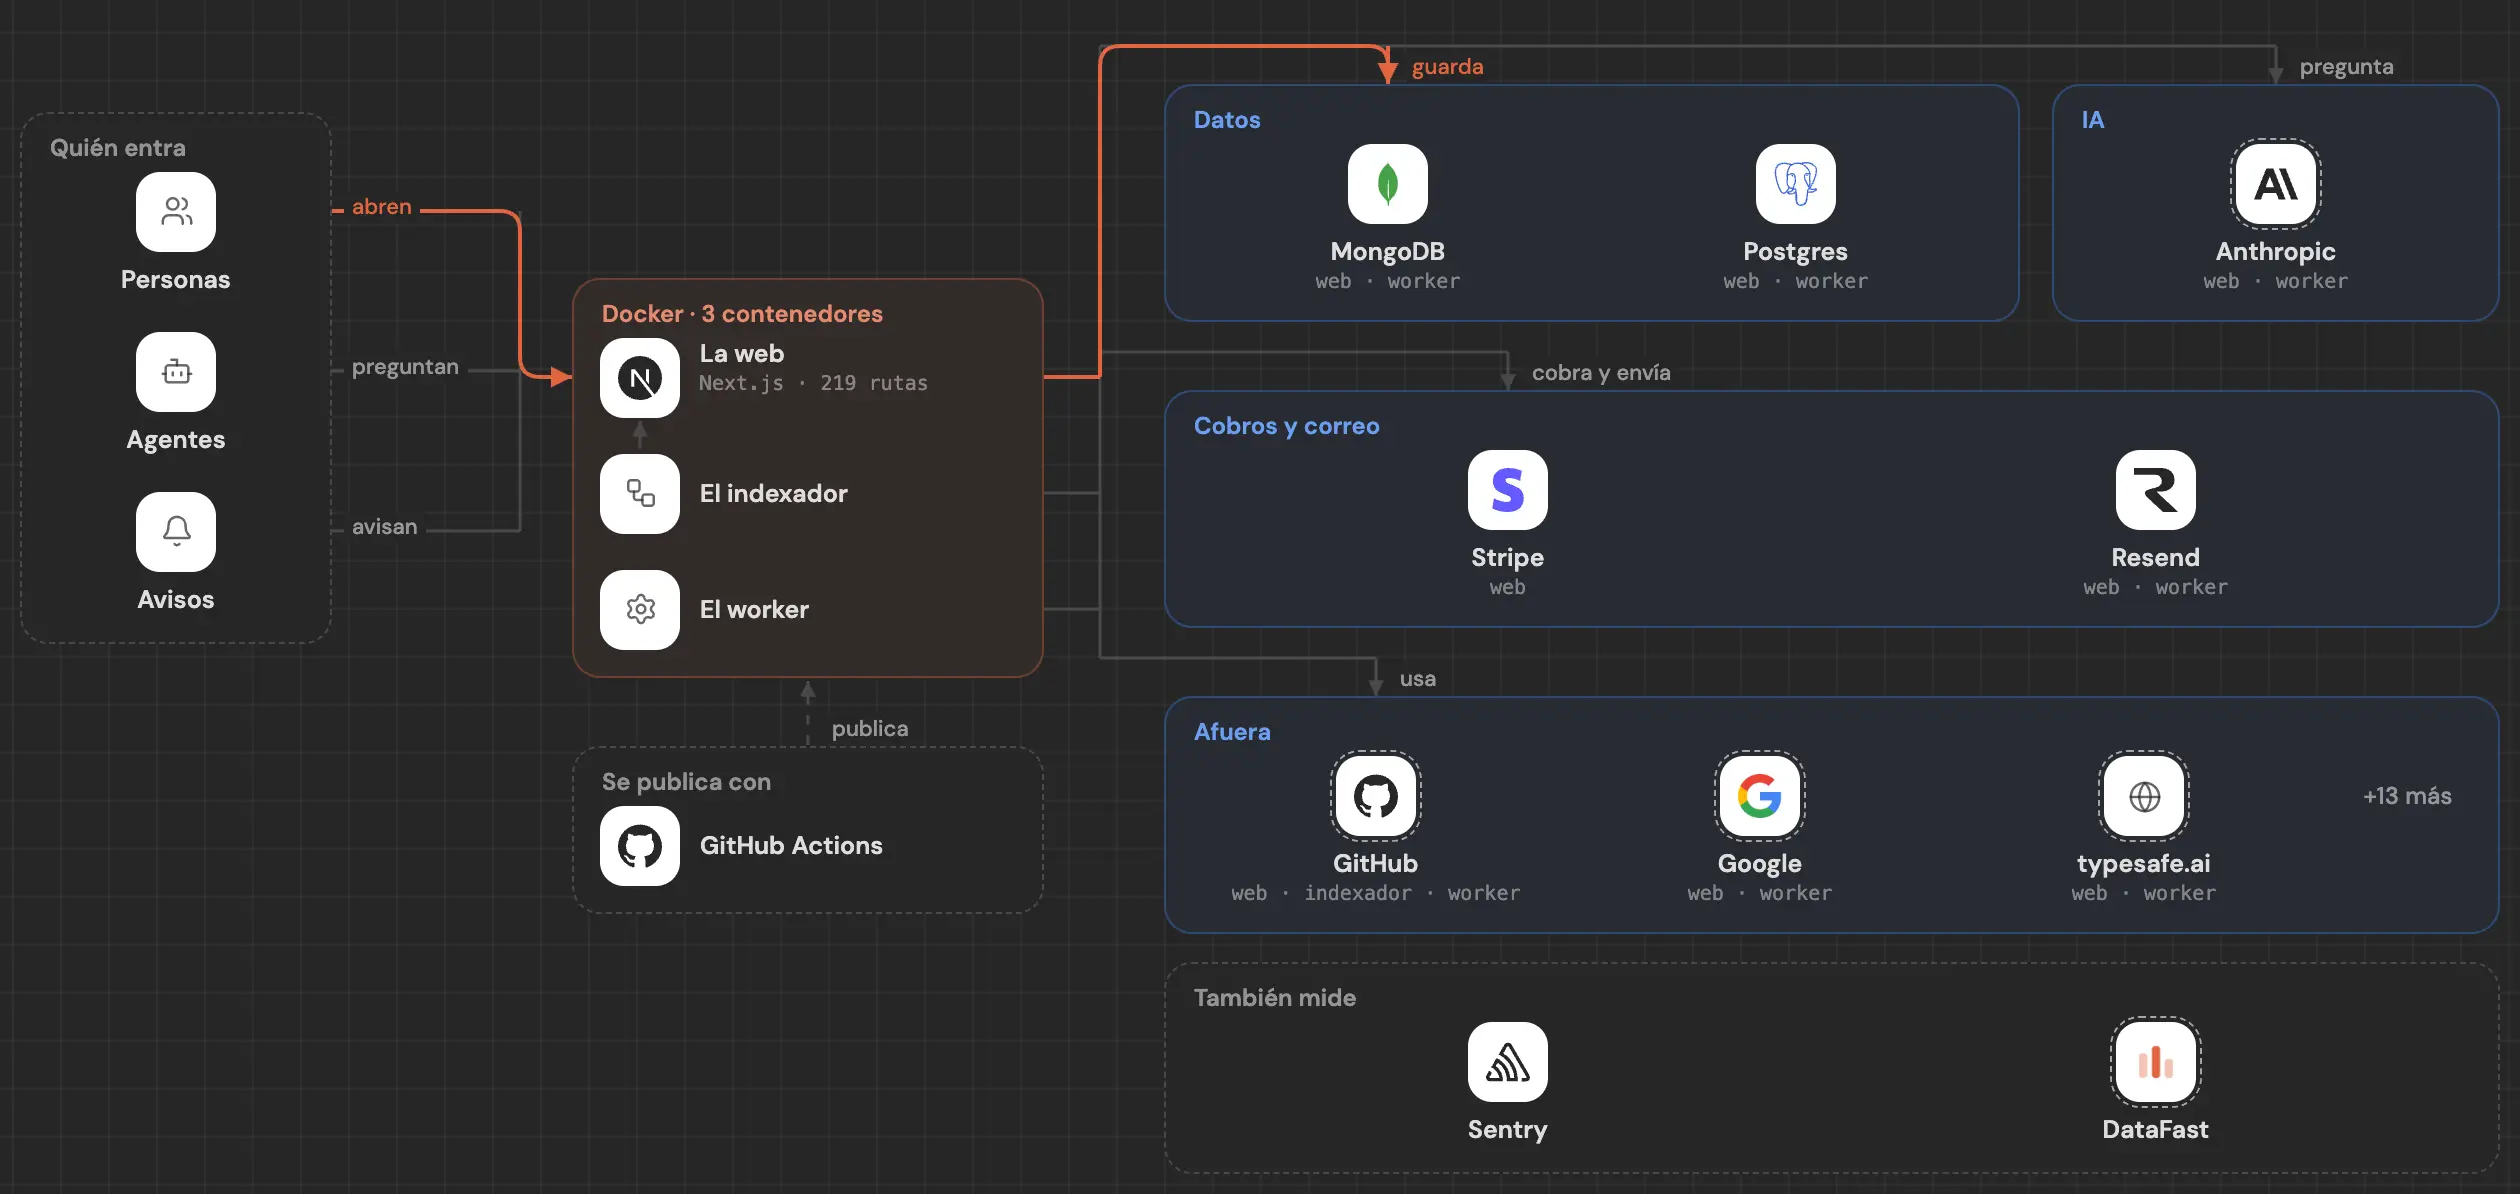
¿Con qué está hecho OCRmyPDF?
OCRmyPDF es un repo de Python. Arma su contenido con fpdf2, pdfminer.six, pikepdf, pillow, pypdfium2 y 1 más y valida sus datos con Pydantic. Son 50,888 líneas escritas, con 97 archivos de prueba.
 LinkedIn
Leído el 7 de noviembre de 2026, en el commit b457e9e. Léela en markdown
Frontend
Interfaz 1
- Rich3 archivos
Apoyo
Otros repos con un stack parecido
Ordenados por cuánto de su stack comparten con OCRmyPDF, y después por estrellas.
- arc53DocsGPT18.4 k
Private AI platform for agents, assistants and enterprise search. Built-in Agent Builder, Deep research, Document analysis, Multi-model support, and API connectivity for agents.
6 de 11 en comúnComparar → - Significant-GravitasAutoGPT187.9 k
AutoGPT is the vision of accessible AI for everyone, to use and to build on. Our mission is to provide the tools, so that you can focus on what matters.
5 de 11 en comúnComparar → - opendatalabMinerU83.1 k
Transforms complex documents like PDFs and Office docs into LLM-ready markdown/JSON for your Agentic workflows.
4 de 11 en comúnComparar →
Preguntas frecuentes
¿En qué lenguaje está escrito OCRmyPDF?
¿OCRmyPDF tiene pruebas?
¿Qué repos tienen un stack parecido a OCRmyPDF?
Mira tu código por dentro, hoy.
Pega tu repo y lo ves dibujado, parte por parte: uno mediano, en menos de un minuto.
Gratis y sin cuenta.


