¿Con qué está hecho ai-infra-book?
ai-infra-book es un repo de Python hecho con FastAPI, anyio, Flask, flask-cors, graphene y 13 más. Accede a sus datos con alembic y SQLAlchemy, inicia sesión con cryptography, itsdangerous y Google, usa IA con accelerate, apache-tvm-ffi, comet-ml, cuda-core, cuda-python y 84 más, arma su contenido con cairosvg, defusedxml, imageio, imageio-ffmpeg, lxml y 13 más, valida sus datos con annotated-types, dacite, fastjsonschema, jsonschema, jsonschema-specifications y 5 más, se prueba con responses, playwright, Pytest y Rich, corre en producción con aiobotocore, boto3, botocore, colorlog, docker y 11 más y usa blobfile, gitdb, huey, pyarrow, redis y 7 más. Son 1,438,355 líneas escritas, con 1,093 archivos de prueba.
 LinkedIn
Leído el 17 de noviembre de 2026, en el commit 3bdcb4f. Léela en markdown
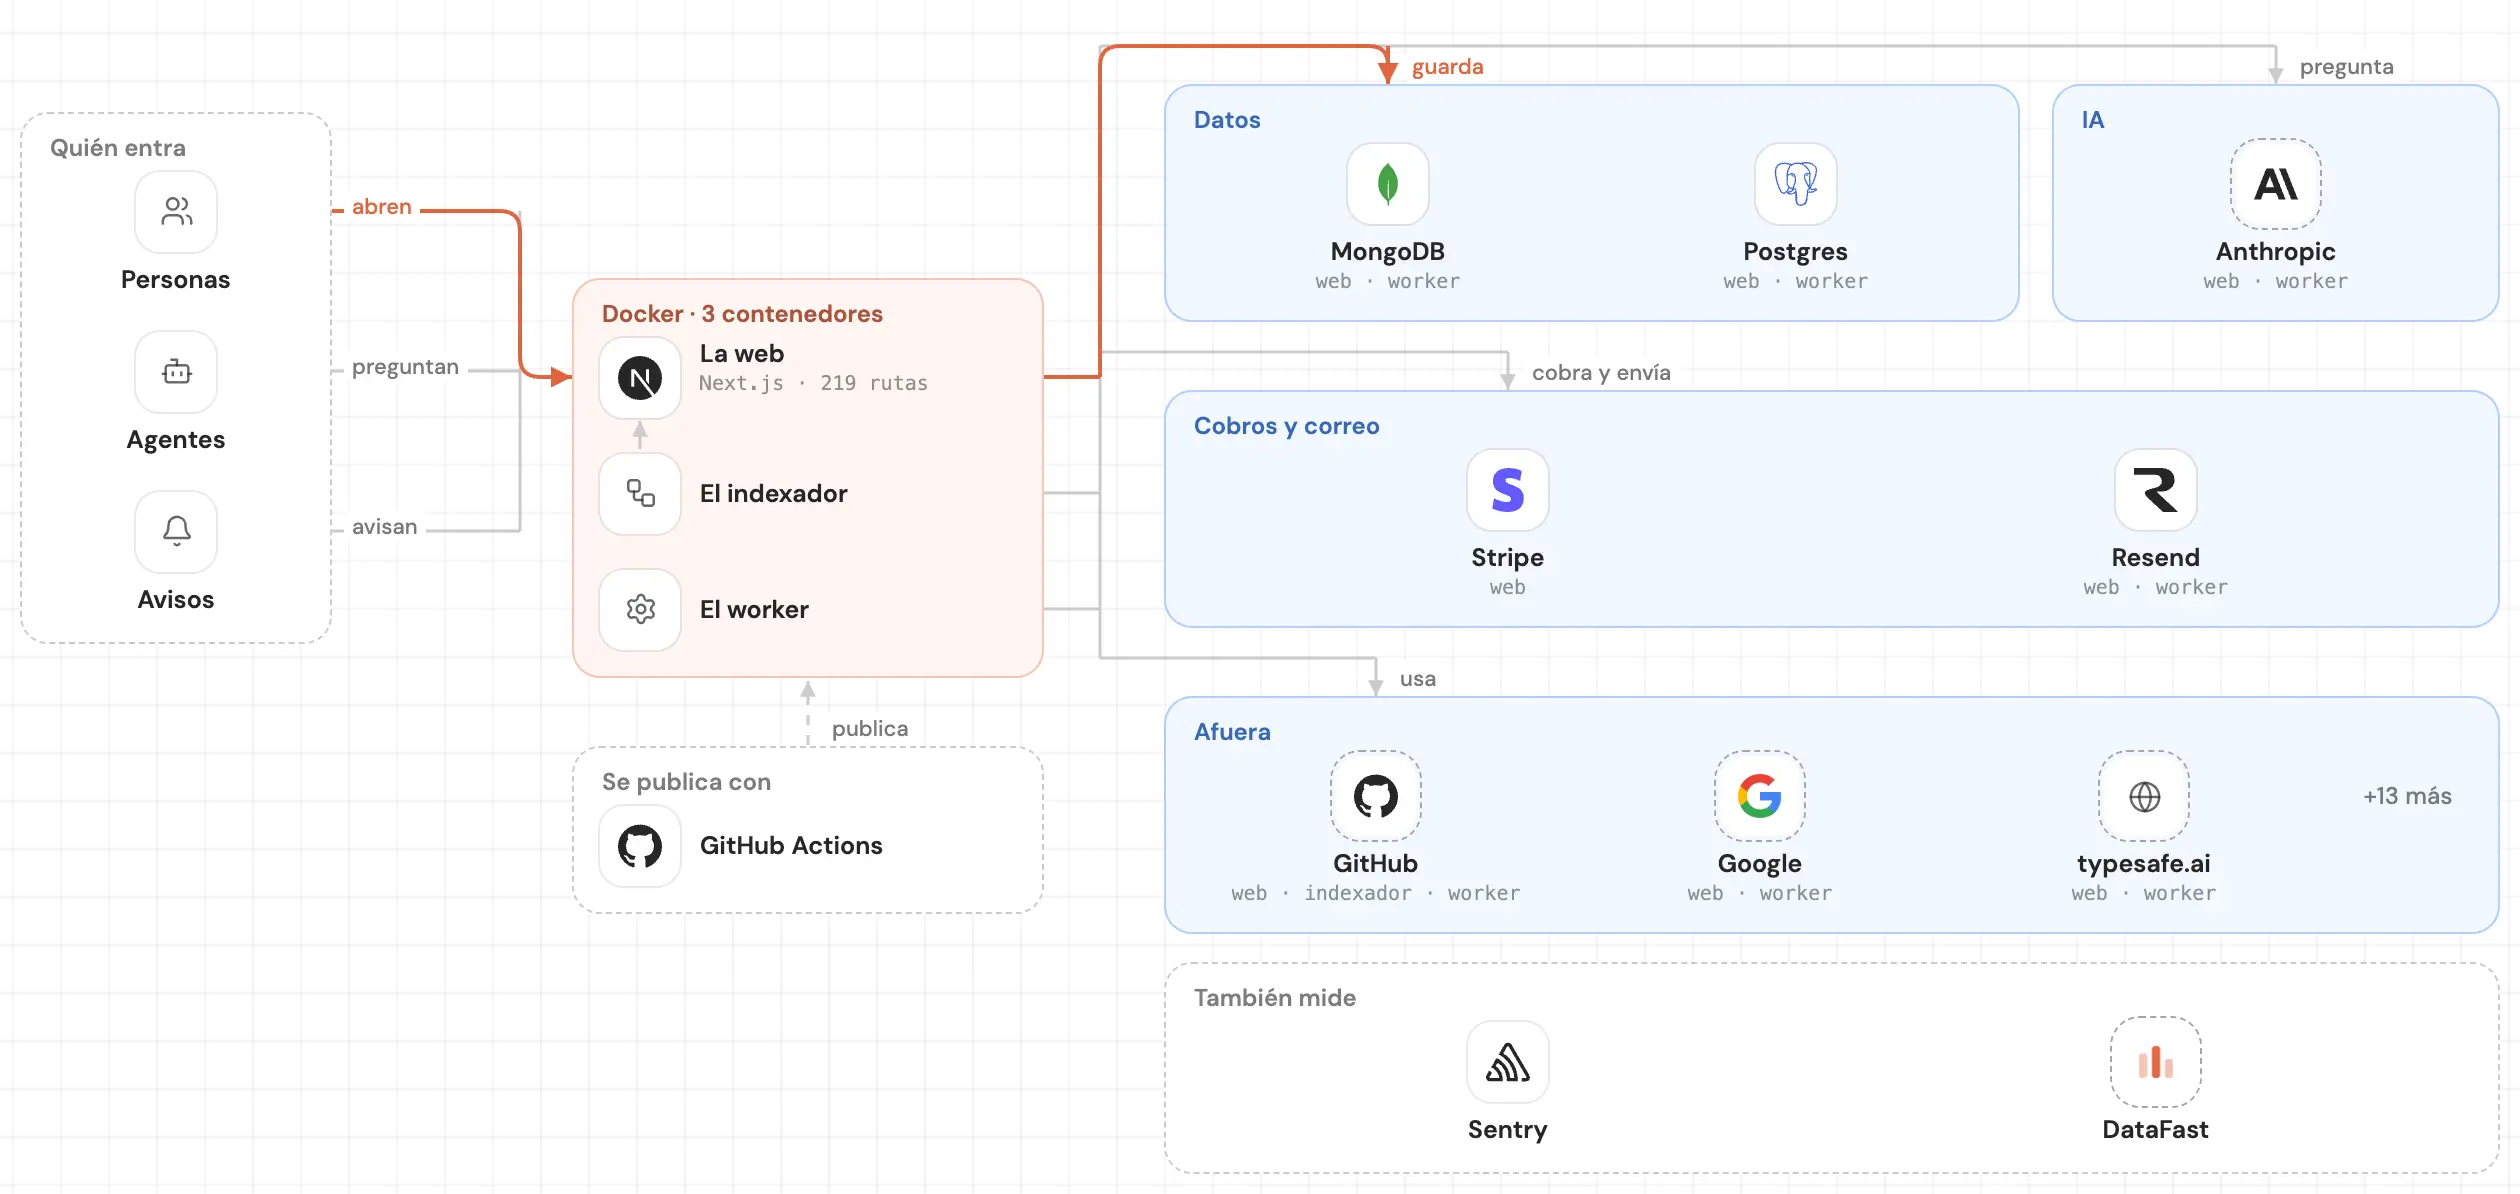
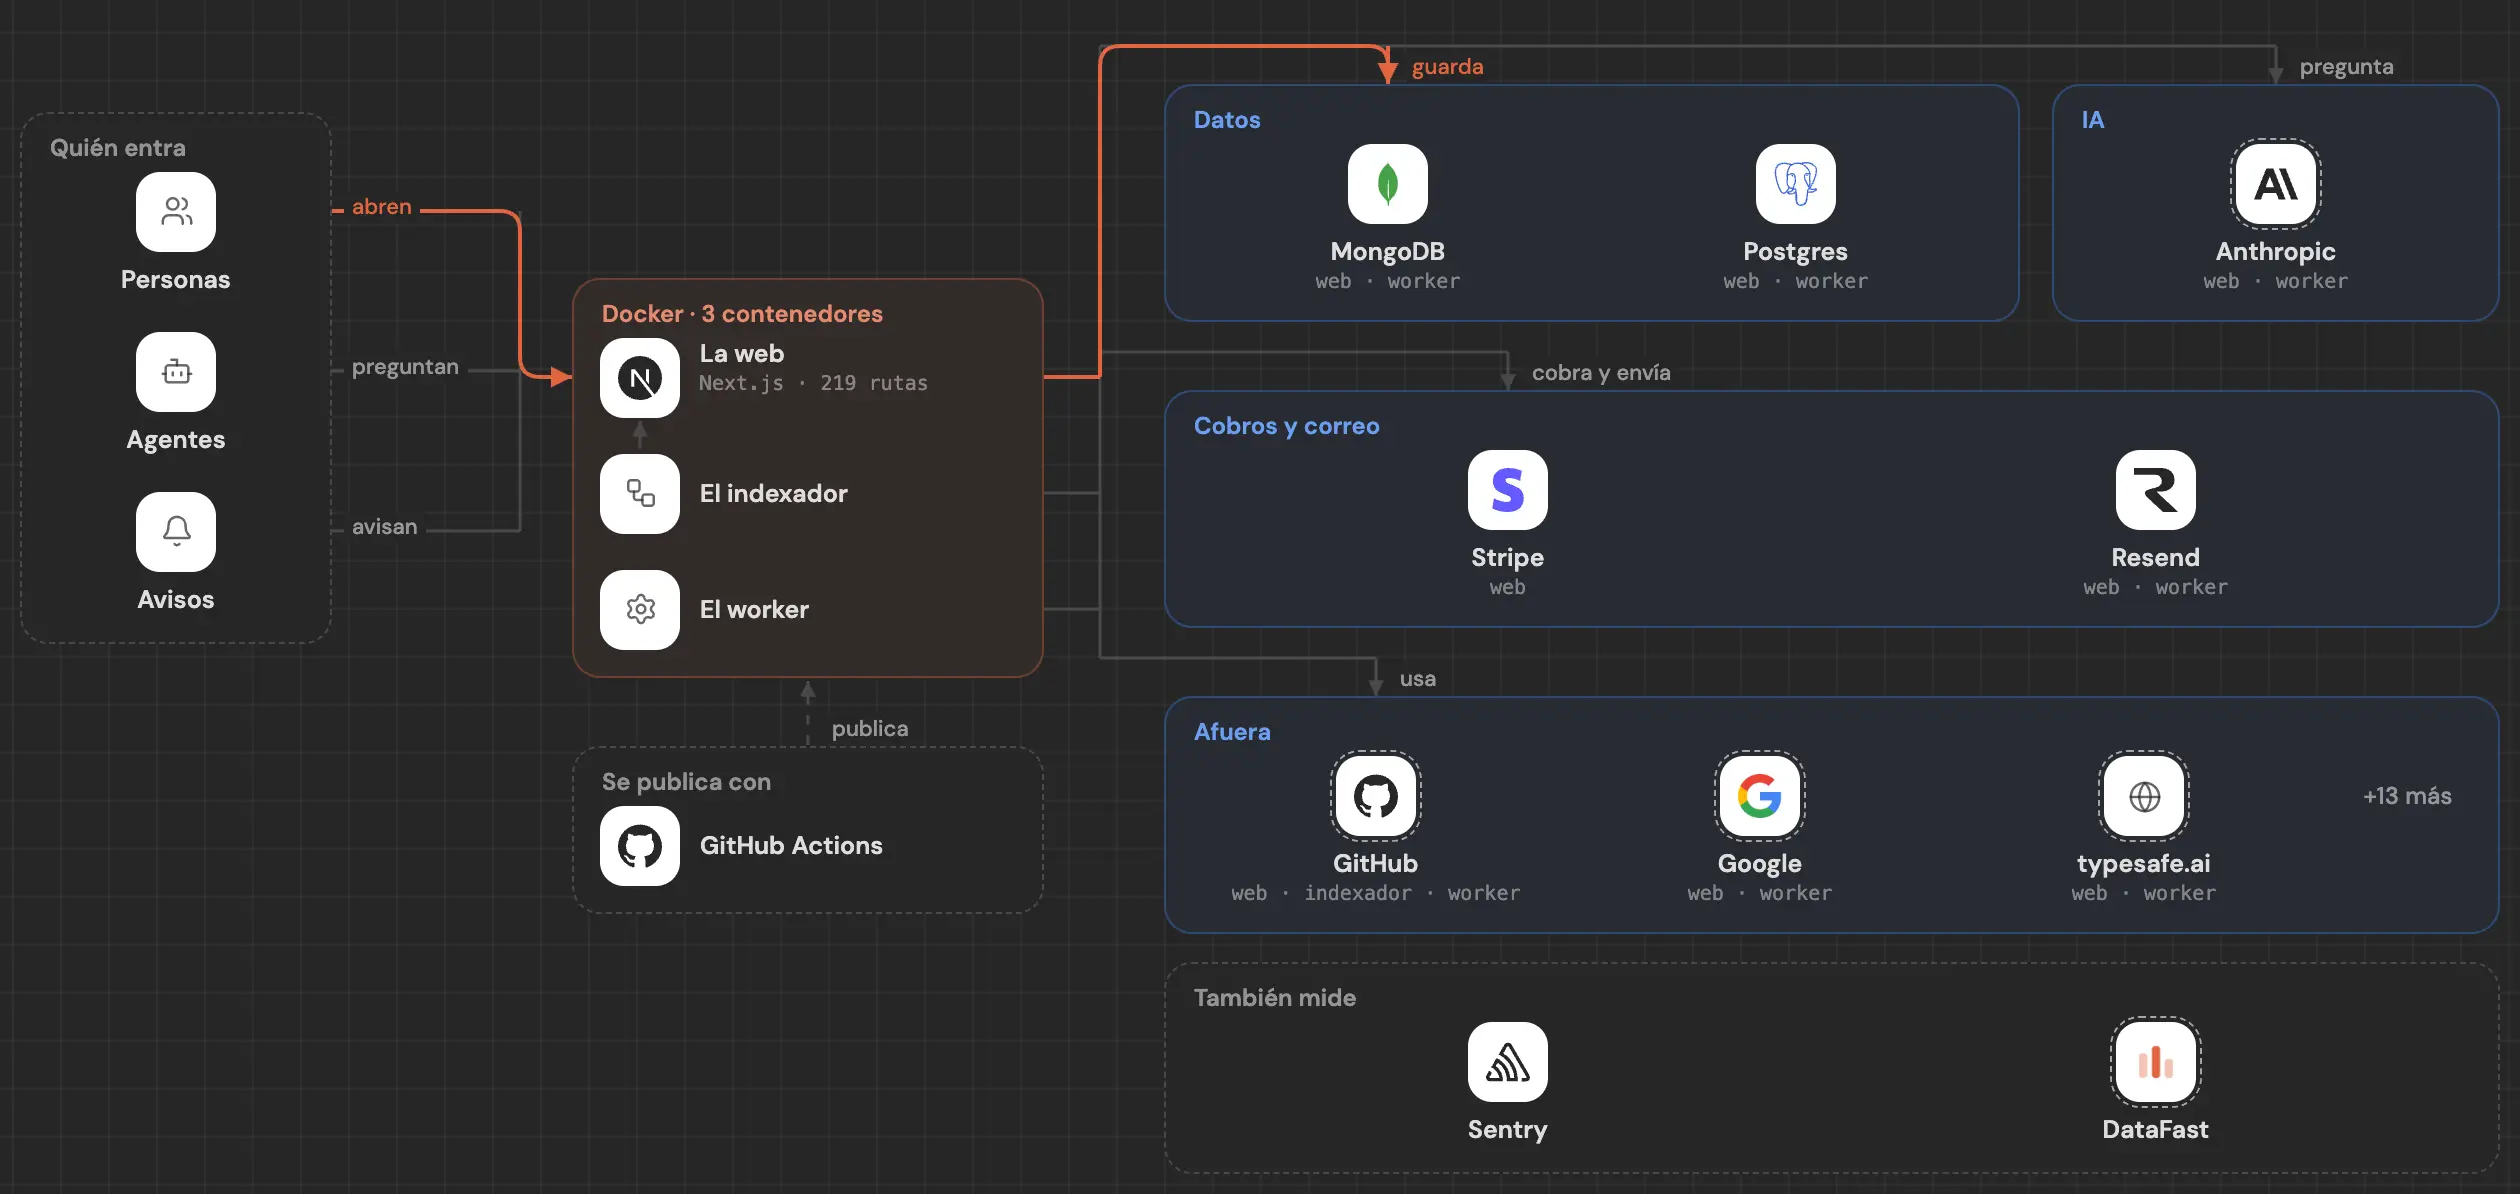
La ficha dice con qué está hecho. Su mapa entero lo abre por dentro: cada parte del código y cómo se conecta con las demás.
Frontend
Estilos 3
fonttools1 archivo
mkdocs-material
- cycler
Interfaz 10
matplotlib249 archivos
contourpy
Gradio
- Plotly
prompt-toolkit
pyecharts
seaborn
- blessed
- kaleido
- matplotlib-inline
Backend
La base 1
FastAPI3 archivos
Datos 11
pyarrow
- redis
tensorboard-data-server
- pyzmq9 archivos
- blobfile
- gitdb
- huey
- s3fs
- s3transfer
- smart-open
- transferqueue
Acceso a los datos 2
Inicio de sesión 3
- Google2 archivos
itsdangerous
- cryptography
IA 88
- torch326 archivos
torchvision20 archivos
tensordict11 archivos
safetensors10 archivos
- ONNX4 archivos
deepspeed3 archivos
diffusers3 archivos
jax3 archivos
librosa3 archivos
torchaudio3 archivos
- ModelScope1 archivo
tokenizers1 archivo
accelerate
apache-tvm-ffi
cupy-cuda13x
descript-audio-codec
e2b
evaluate
fla-core
flashinfer-cubin
mcp
- MLflow
mlx
mooncake-transfer-engine-cuda13
nltk
- nvidia-cublas
nvidia-cudnn-frontend
onnx-ir
onnxscript
openai
openai-agents
peft
pythainlp
rouge-score
- scikit-learn
skops
- spaCy
spacy-legacy
stanza
thinc
timm
- transformers51 archivos
- triton11 archivos
- einops9 archivos
- flash-attn9 archivos
- megatron-core8 archivos
- datasets5 archivos
- xformers5 archivos
- causal-conv1d1 archivo
- cuda-bindings1 archivo
- nvidia-cuda-runtime1 archivo
- torchdata1 archivo
- transformer-engine1 archivo
- comet-ml
- cuda-core
- cuda-python
- cuda-toolkit
- decord2
- einx
- emerging-optimizers
- llvmlite
- loralib
- mamba-ssm
- math-verify
- megatron-bridge
- mistral-common
- ml-dtypes
- mlx-lm
- nixl
- nvidia-cudnn-cu12
- nvidia-cudnn-cu13
- nvidia-cufft
- nvidia-cusolver
- nvidia-cusparse
- nvshmem4py-cu13
- open-clip-torch
- opt-einsum
- qwen-vl-utils
- sacrebleu
- sentencepiece
- sglang-router
- silero-vad
- sklearn-crfsuite
- tiktoken
- torch-c-dlpack-ext
Apoyo
La base 17
- Ray14 archivos
- AIOHTTP2 archivos
Flask
- jupyter-core
- Lightning
quart
starlette
tornado
uvicorn
werkzeug
- anyio
- flask-cors
- graphene
- graphql-core
- graphql-relay
- hypercorn
- kui
Contenido 18
pillow29 archivos
pymupdf3 archivos
av1 archivo
- jinja21 archivo
imageio
imageio-ffmpeg
lxml
markdown-it-py
markupsafe
- markdown87 archivos
- cairosvg
- defusedxml
- mako
- mdurl
- nbformat
- pylatexenc
- pytablewriter
- python-magic
Validación 10
msgspec11 archivos
- Pydantic8 archivos
- annotated-types
- dacite
- fastjsonschema
- jsonschema
- jsonschema-specifications
- pathvalidate
- referencing
- typepy
Pruebas 4
playwright28 archivos
- Pytest15 archivos
- Rich1 archivo
- responses
Despliegue 16
psutil5 archivos
loguru3 archivos
prometheus-client3 archivos
- docker
- Gunicorn
OpenTelemetry
swanlab
- aiobotocore
- boto3
- botocore
- colorlog
- gpustat
- opencensus-context
- spacy-loggers
Herramientas 61
click2 archivos
- Setuptools1 archivo
- Typer1 archivo
antlr4-python3-runtime
cython
hatchling
ipython
isort
jedi
- Jupyter
memray
ninja
Numba
- nvidia-cuda-cupti
parso
- pre-commit
pybind11
pygments
pylint
pyrefly
python-discovery
Ruff
virtualenv
- packaging9 archivos
- typing-extensions9 archivos
- tilelang3 archivos
- pyrootutils1 archivo
- annotated-doc
- astroid
- asttokens
- autocommand
- cfgv
- cuda-pathfinder
- cuda-tile
- debugpy
- distlib
- docopt
- executing
- gitpython
- grpcio-tools
- identify
- iniconfig
- ipykernel
- mccabe
- nodeenv
- pathspec
- pip
- pluggy
- pure-eval
- py-spy
- pycparser
- pyvers
- setuptools-scm
- shellingham
- stack-data
- trove-classifiers
- typeguard
- types-pyyaml
- types-requests
- wheel
Otras 169
- NumPy296 archivos
github.com/apernet/quic-go65 archivos
- tqdm12 archivos
omegaconf10 archivos
- pandas5 archivos
SciPy5 archivos
networkx3 archivos
- SymPy2 archivos
pyyaml1 archivo
wrapt1 archivo
absl-py
aioquic
attrs
awscrt
certifi
colored
filelock
fsspec
google-api-core
hf-xet
hjson
hydra-core
joblib
msgpack
narwhals
- NVIDIA
nvidia-ml-py
platformdirs
portalocker
prettytable
pyaudio
pycryptodomex
pyopenssl
python-box
python-dateutil
requests-toolbelt
termcolor
urllib3
wandb
- requests33 archivos
- golang.org/x/sys15 archivos
- soundfile6 archivos
- httpx3 archivos
- regex3 archivos
- ftfy1 archivo
- pulp1 archivo
- pybase641 archivo
- setproctitle1 archivo
- sortedcontainers1 archivo
- aenum
- aiofile
- aiofiles
- aiohappyeyeballs
- aiohttp-cors
- aioitertools
- aiosignal
- async-timeout
- backports.tarfile
- blake3
- blinker
- blis
- cachetools
- catalogue
- cffi
- chardet
- charset-normalizer
- cloudpathlib
- cloudpickle
- colorama
- colorful
- comm
- confection
- configobj
- cufile-python
- cymem
- dataproperty
- decorator
- dill
- dulwich
- emoji
- everett
- exceptiongroup
- faust-cchardet
- frozenlist
- greenlet
- grpcio
- h11
- h2
- hpack
- httpcore
- httptools
- humanize
- hyperframe
- idna
- importlib-metadata
- inflect
- jaraco.context
- jaraco.functools
- jaraco.text
- jieba
- jmespath
- kiwisolver
- langcodes
- latex2sympy2-extended
- mbstrdecoder
- more-itertools
- mpmath
- multidict
- multiprocess
- murmurhash
- natsort
- nccl4py
- nest-asyncio
- net
- num2words
- nvtx
- opencc-python-reimplemented
- opencensus
- orjson
- ormsgpack
- pexpect
- preshed
- priority
- propcache
- protobuf
- ptyprocess
- py-cpuinfo
- pyasn1
- pyasn1-modules
- pycountry
- pydub
- pylsqpack
- pyparsing
- python-dotenv
- pytz
- pyvi
- resampy
- rpds-py
- semantic-version
- service-identity
- simplejson
- six
- smmap
- sniffio
- sqlparse
- srsly
- tabledata
- tabulate
- tcolorpy
- threadpoolctl
- tomli
- tomlkit
- traitlets
- typing-inspection
- tzdata
- wasabi
- wcwidth
- weasel
- word2number
- wsproto
- wurlitzer
- xxhash
- yarl
- z3-solver
- zipp
- zstandard
Otros repos con un stack parecido
Ordenados por cuánto de su stack comparten con ai-infra-book, y después por estrellas.
- ray-projectray44.3 k
Ray is an AI compute engine. Ray consists of a core distributed runtime and a set of AI Libraries for accelerating ML workloads.
99 de 415 en comúnComparar → - run-llamallama_index52.9 k
LlamaIndex is the document processing platform for AI
51 de 415 en comúnComparar → - apachesuperset75.5 k
Apache Superset is a Data Visualization and Data Exploration Platform
49 de 415 en comúnComparar → - vllm-projectvllm97.1 k
A high-throughput and memory-efficient inference and serving engine for LLMs
39 de 415 en comúnComparar → - mudlerLocalAI50.4 k
LocalAI is the open-source AI engine. Run any model - LLMs, vision, voice, image, video - on any hardware. No GPU required.
38 de 415 en común · GoComparar →
Preguntas frecuentes
¿En qué lenguaje está escrito ai-infra-book?
¿Qué framework usa ai-infra-book?
¿Con qué inicia sesión ai-infra-book?
¿ai-infra-book usa IA?
¿Qué servicios usa ai-infra-book?
¿ai-infra-book tiene pruebas?
¿Qué repos tienen un stack parecido a ai-infra-book?
Mira tu código por dentro, hoy.
Pega tu repo y lo ves dibujado, parte por parte: uno mediano, en menos de un minuto.
Gratis y sin cuenta.¿Repo privado? Entra con GitHub


