¿Con qué está hecho MemoryBear?
MemoryBear es un repo de Python hecho con FastAPI, Actix Web, uvicorn, Flask, werkzeug y 8 más. Guarda sus datos en Postgres, accede a ellos con SQLAlchemy y alembic, inicia sesión con authlib, bcrypt, ecdsa, itsdangerous, keyring y 4 más, usa IA con crcmod, langchain-mcp-adapters, langfuse, langgraph-sdk, langsmith y 19 más, arma su contenido con docutils, et-xmlfile, html5lib, mako, markdown-it-py y 36 más, valida sus datos con annotated-types, demjson3, email-validator, jsonschema, jsonschema-path y 6 más, se prueba con Pytest y pytest-asyncio, se despliega con Flower, OpenTelemetry, opentelemetry-semantic-conventions, volcengine-python-sdk, botocore y 6 más y usa amqp, asyncpg, psycopg, psycopg2-binary, py-key-value-aio y 10 más. Son 773,759 líneas escritas, con 48 archivos de prueba.
 LinkedIn
Leído el 13 de noviembre de 2026, en el commit 9ba1071. Léela en markdown
La ficha dice con qué está hecho. Su mapa entero lo abre por dentro: cada parte del código y cómo se conecta con las demás.
Frontend
Estilos 3
Interfaz 17
antd455 archivos
lexical39 archivos
- AntV31 archivos
echarts-for-react16 archivos
- D311 archivos
echarts5 archivos
dnd-kit3 archivos
- CodeMirror2 archivos
react-syntax-highlighter2 archivos
matplotlib1 archivo
- Mermaid1 archivo
react-fast-marquee1 archivo
react-window1 archivo
prompt-toolkit
- Rich
- react-infinite-scroll-component9 archivos
- echarts-wordcloud2 archivos
La base 3
- React548 archivos · en web/package.json
react-router-dom101 archivos
- Vite1 archivo · en web/package.json
Backend
Datos 14
- Redis53 archivos · api/app/aioRedis.py, línea 8
- Celery18 archivos
- Neo4j12 archivos
- Postgres11 archivos · api/app/core/tools/builtin/database_tool.py, línea 1
kombu2 archivos
elasticsearch-dsl1 archivo
valkey1 archivo
psycopg
psycopg2-binary
- oss23 archivos
- amqp
- asyncpg
- py-key-value-aio
- s3transfer
Acceso a los datos 2
- SQLAlchemy564 archivos
- alembic1 archivo
Inicio de sesión 9
authlib
itsdangerous
- python-jose8 archivos
- cryptography1 archivo
- passlib1 archivo
- pyjwt1 archivo
- bcrypt
- ecdsa
- keyring
IA 23
- LangChain76 archivos
- LangGraph27 archivos
dashscope8 archivos
langchain-openai5 archivos
opencv-python5 archivos
nltk2 archivos
chonkie1 archivo
- ModelScope1 archivo
- Ollama1 archivo
- scikit-learn1 archivo
langchain-mcp-adapters
Servicios 3
Apoyo
La base 6
Contenido 41
pillow30 archivos
- jinja225 archivos
pypdf5 archivos
olefile3 archivos
pypdf23 archivos
pymupdf2 archivos
lxml1 archivo
pdfjs-dist1 archivo
rehype-katex1 archivo
rehype-raw1 archivo
remark-breaks1 archivo
remark-gfm1 archivo
xlsx1 archivo
et-xmlfile
markdown-it-py
markupsafe
rich-rst
ruamel-yaml
webencodings
- openpyxl13 archivos
- beautifulsoup412 archivos
- python-magic6 archivos
- markdown5 archivos
- pdfplumber4 archivos
- xlrd4 archivos
- react-markdown3 archivos
- mammoth2 archivos
- python-calamine2 archivos
- python-pptx2 archivos
- tika2 archivos
- html2canvas1 archivo
- js-yaml1 archivo
- markdownify1 archivo
- docutils
- html5lib
- mako
- mdurl
- python-docx
- python-magic-bin
Validación 11
- Pydantic336 archivos
beartype1 archivo
marshmallow
- annotated-types
- demjson3
- email-validator
- jsonschema
- jsonschema-path
- jsonschema-specifications
- openapi-pydantic
- referencing
Pruebas 2
- Pytest30 archivos
pytest-asyncio1 archivo
Despliegue 11
prometheus-client6 archivos
tracing6 archivos
psutil2 archivos
- Flower
- OpenTelemetry
opentelemetry-semantic-conventions
- botocore9 archivos
- boto33 archivos
- concurrent-log-handler1 archivo
- volcengine-python-sdk
Herramientas 14
click
cyclopts
pygments
- typing-extensions2 archivos
- packaging1 archivo
- celery-types
- click-didyoumean
- click-plugins
- click-repl
- docstring-parser
- mypy-extensions
- pycparser
- typing-inspect
- watchfiles
Otras 132
dayjs30 archivos
- NumPy27 archivos
pyyaml15 archivos
trio15 archivos
networkx10 archivos
- i18next9 archivos
- pandas6 archivos
zustand6 archivos
pydantic-settings5 archivos
- Axios3 archivos
rdflib2 archivos
websockets2 archivos
landlock1 archivo
- Matter.js1 archivo
python-dateutil1 archivo
recordrtc1 archivo
aliyun-python-sdk-core
aliyun-python-sdk-kms
attrs
certifi
dnspython
googleapis-common-protos
joblib
- opentelemetry-exporter-otlp-proto-common
platformdirs
portalocker
pycryptodome
requests-toolbelt
- tqdm
urllib3
wrapt
- react-i18next392 archivos
- clsx146 archivos
- httpx73 archivos
- requests28 archivos
- copy-to-clipboard20 archivos
- json-repair19 archivos
- python-dotenv17 archivos
- chardet7 archivos
- libc5 archivos
- serde_json5 archivos
- xxhash5 archivos
- aiofiles4 archivos
- tenacity4 archivos
- base643 archivos
- deprecated3 archivos
- serde3 archivos
- strenum3 archivos
- orjson2 archivos
- pytz2 archivos
- simpleeval2 archivos
- async-channel1 archivo
- billiard1 archivo
- cachetools1 archivo
- cn2an1 archivo
- crypto-js1 archivo
- editdistance1 archivo
- jieba1 archivo
- pyclipper1 archivo
- rand1 archivo
- shapely1 archivo
- six1 archivo
- subtle1 archivo
- toml1 archivo
- word2number1 archivo
- aiofile
- aiohappyeyeballs
- aiosignal
- async-timeout
- backoff
- blinker
- caio
- cffi
- charset-normalizer
- colorama
- dataclasses-json
- distro
- exceptiongroup
- frozenlist
- greenlet
- grpcio
- grpcio-health-checking
- h11
- httpcore
- httptools
- httpx-sse
- idna
- importlib-metadata
- jaraco-classes
- jaraco-context
- jaraco-functools
- jeepney
- jiter
- jmespath
- jsonpatch
- jsonpointer
- jsonref
- more-itertools
- multidict
- ormsgpack
- outcome
- pathable
- propcache
- protobuf
- pyasn1
- pyparsing
- pyperclip
- python-multipart
- pywin32
- pywin32-ctypes
- regex
- rpds-py
- rsa
- s
- secretstorage
- sniffio
- sortedcontainers
- sse-starlette
- tomli
- typing-inspection
- tzdata
- uncalled-for
- uuid
- uuid-utils
- uvloop
- vine
- wcwidth
- websocket-client
- yarl
- zipp
- zstandard
Otros repos con un stack parecido
Ordenados por cuánto de su stack comparten con MemoryBear, y después por estrellas.
- apachesuperset75.5 k
Apache Superset is a Data Visualization and Data Exploration Platform
66 de 295 en comúnComparar → - run-llamallama_index52.9 k
LlamaIndex is the document processing platform for AI
53 de 295 en comúnComparar → - bojieliai-agent-book57.9 k
《深入理解 AI Agent:设计原理与工程实践》(李博杰 著)开源主仓库:全书正文、编译版 PDF 与按章配套代码
43 de 295 en comúnComparar → - open-webuiopen-webui158.4 k
User-friendly AI Interface (Supports Ollama, OpenAI API, ...)
41 de 295 en común · SvelteComparar → - Significant-GravitasAutoGPT188 k
AutoGPT is the vision of accessible AI for everyone, to use and to build on. Our mission is to provide the tools, so that you can focus on what matters.
35 de 295 en comúnComparar →
Preguntas frecuentes
¿En qué lenguaje está escrito MemoryBear?
¿Qué framework usa MemoryBear?
¿Qué base de datos usa MemoryBear?
La prueba: api/app/core/tools/builtin/database_tool.py, línea 1
¿Con qué inicia sesión MemoryBear?
¿MemoryBear usa IA?
¿Qué servicios usa MemoryBear?
¿MemoryBear tiene pruebas?
¿Qué repos tienen un stack parecido a MemoryBear?
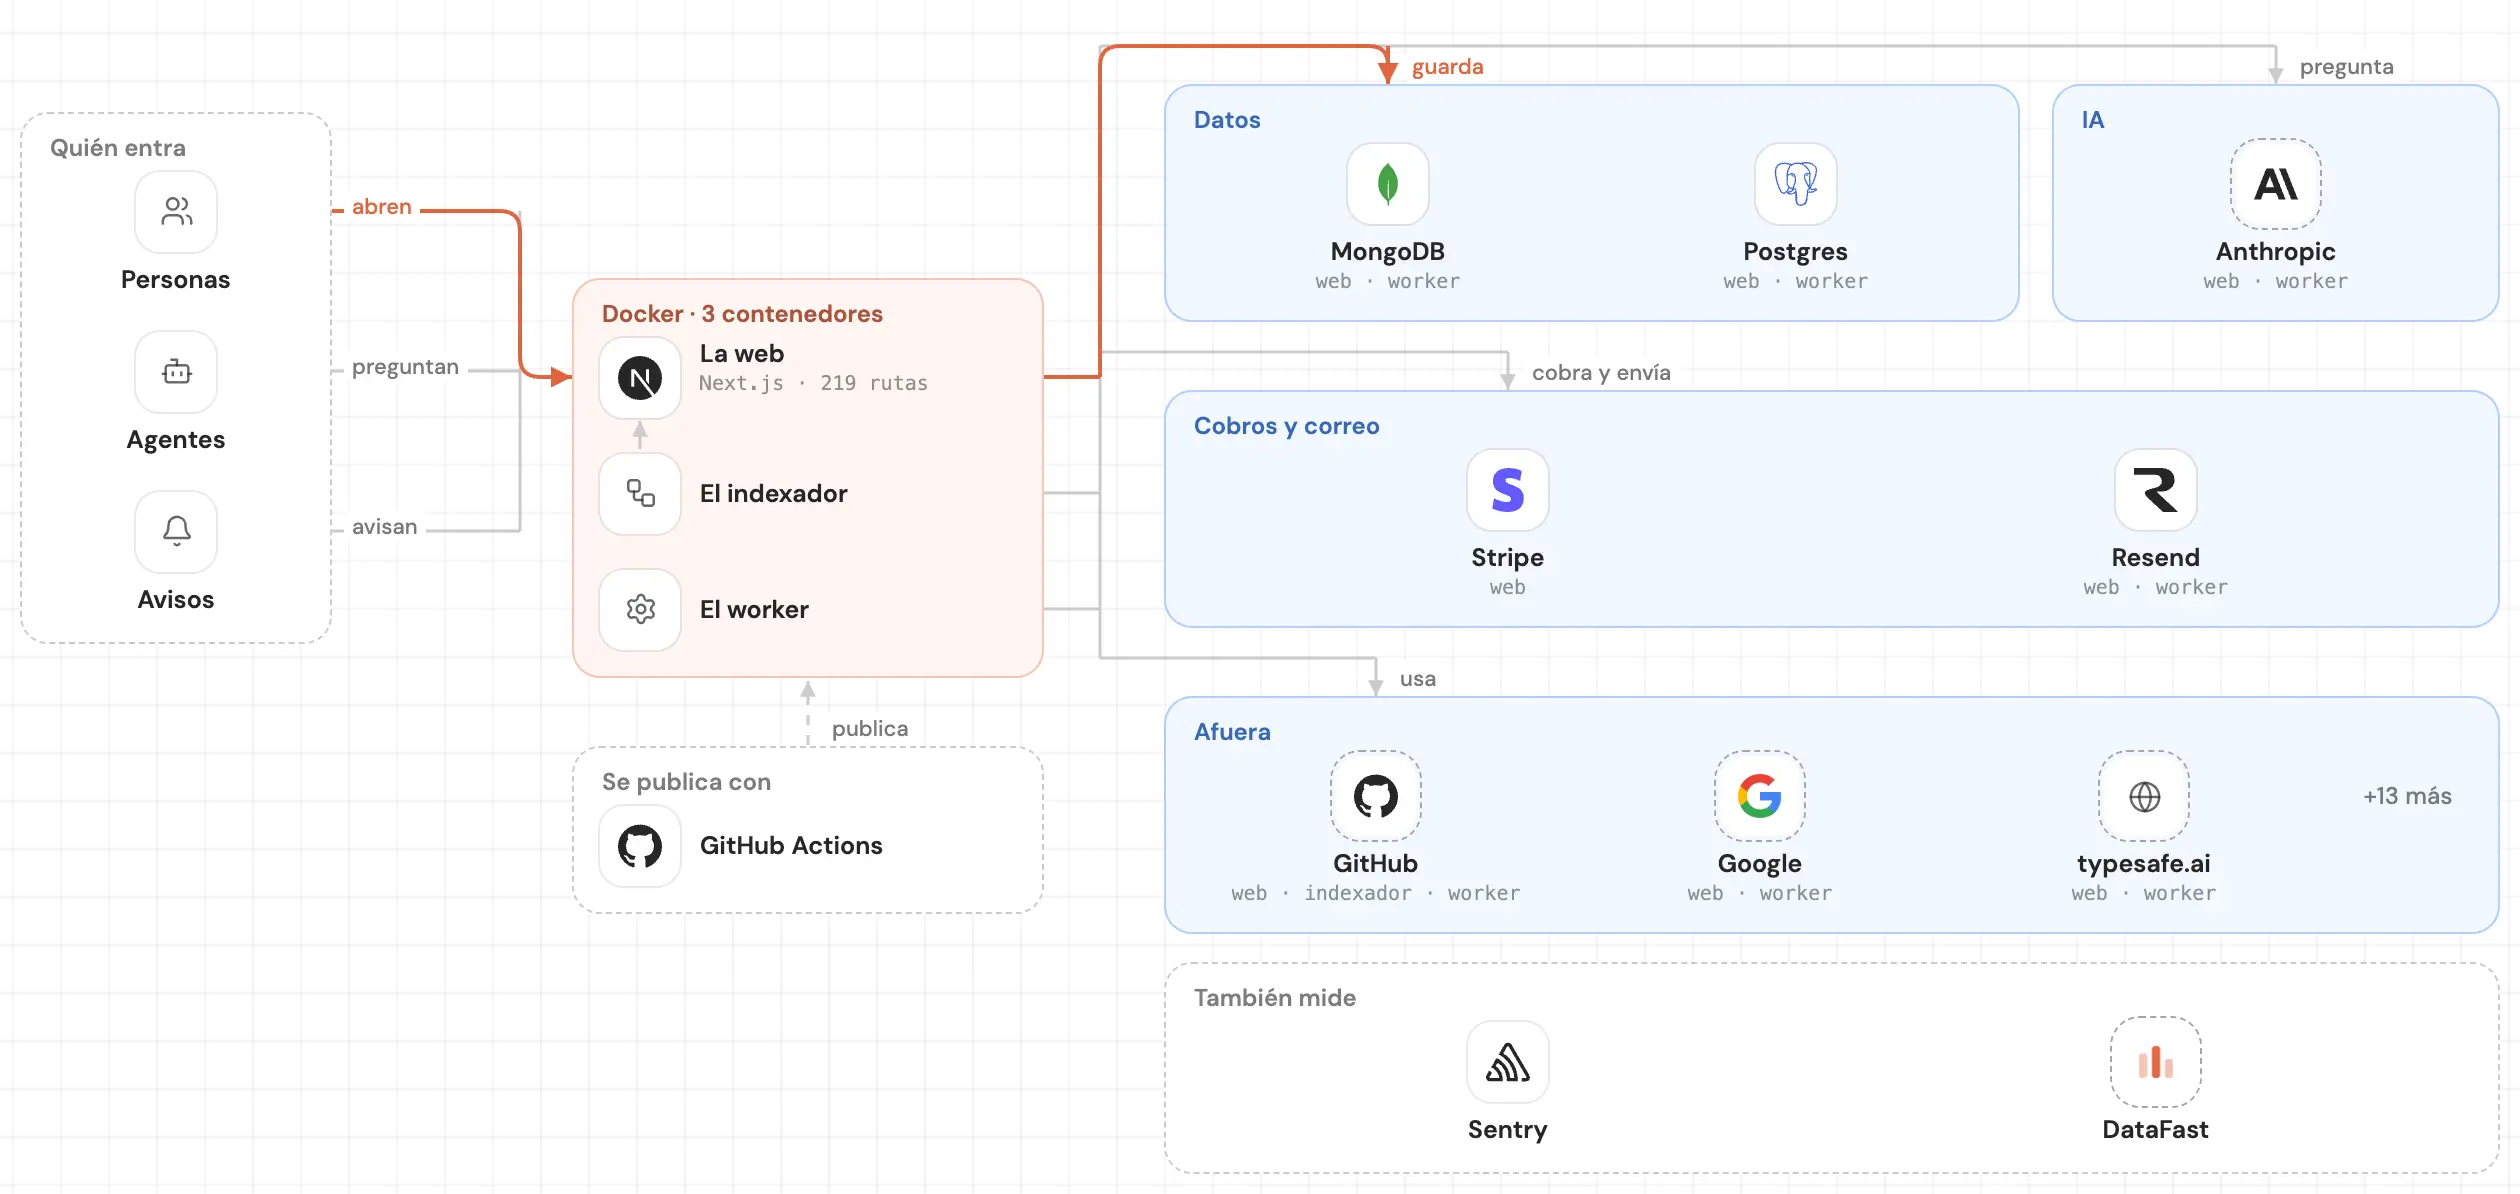
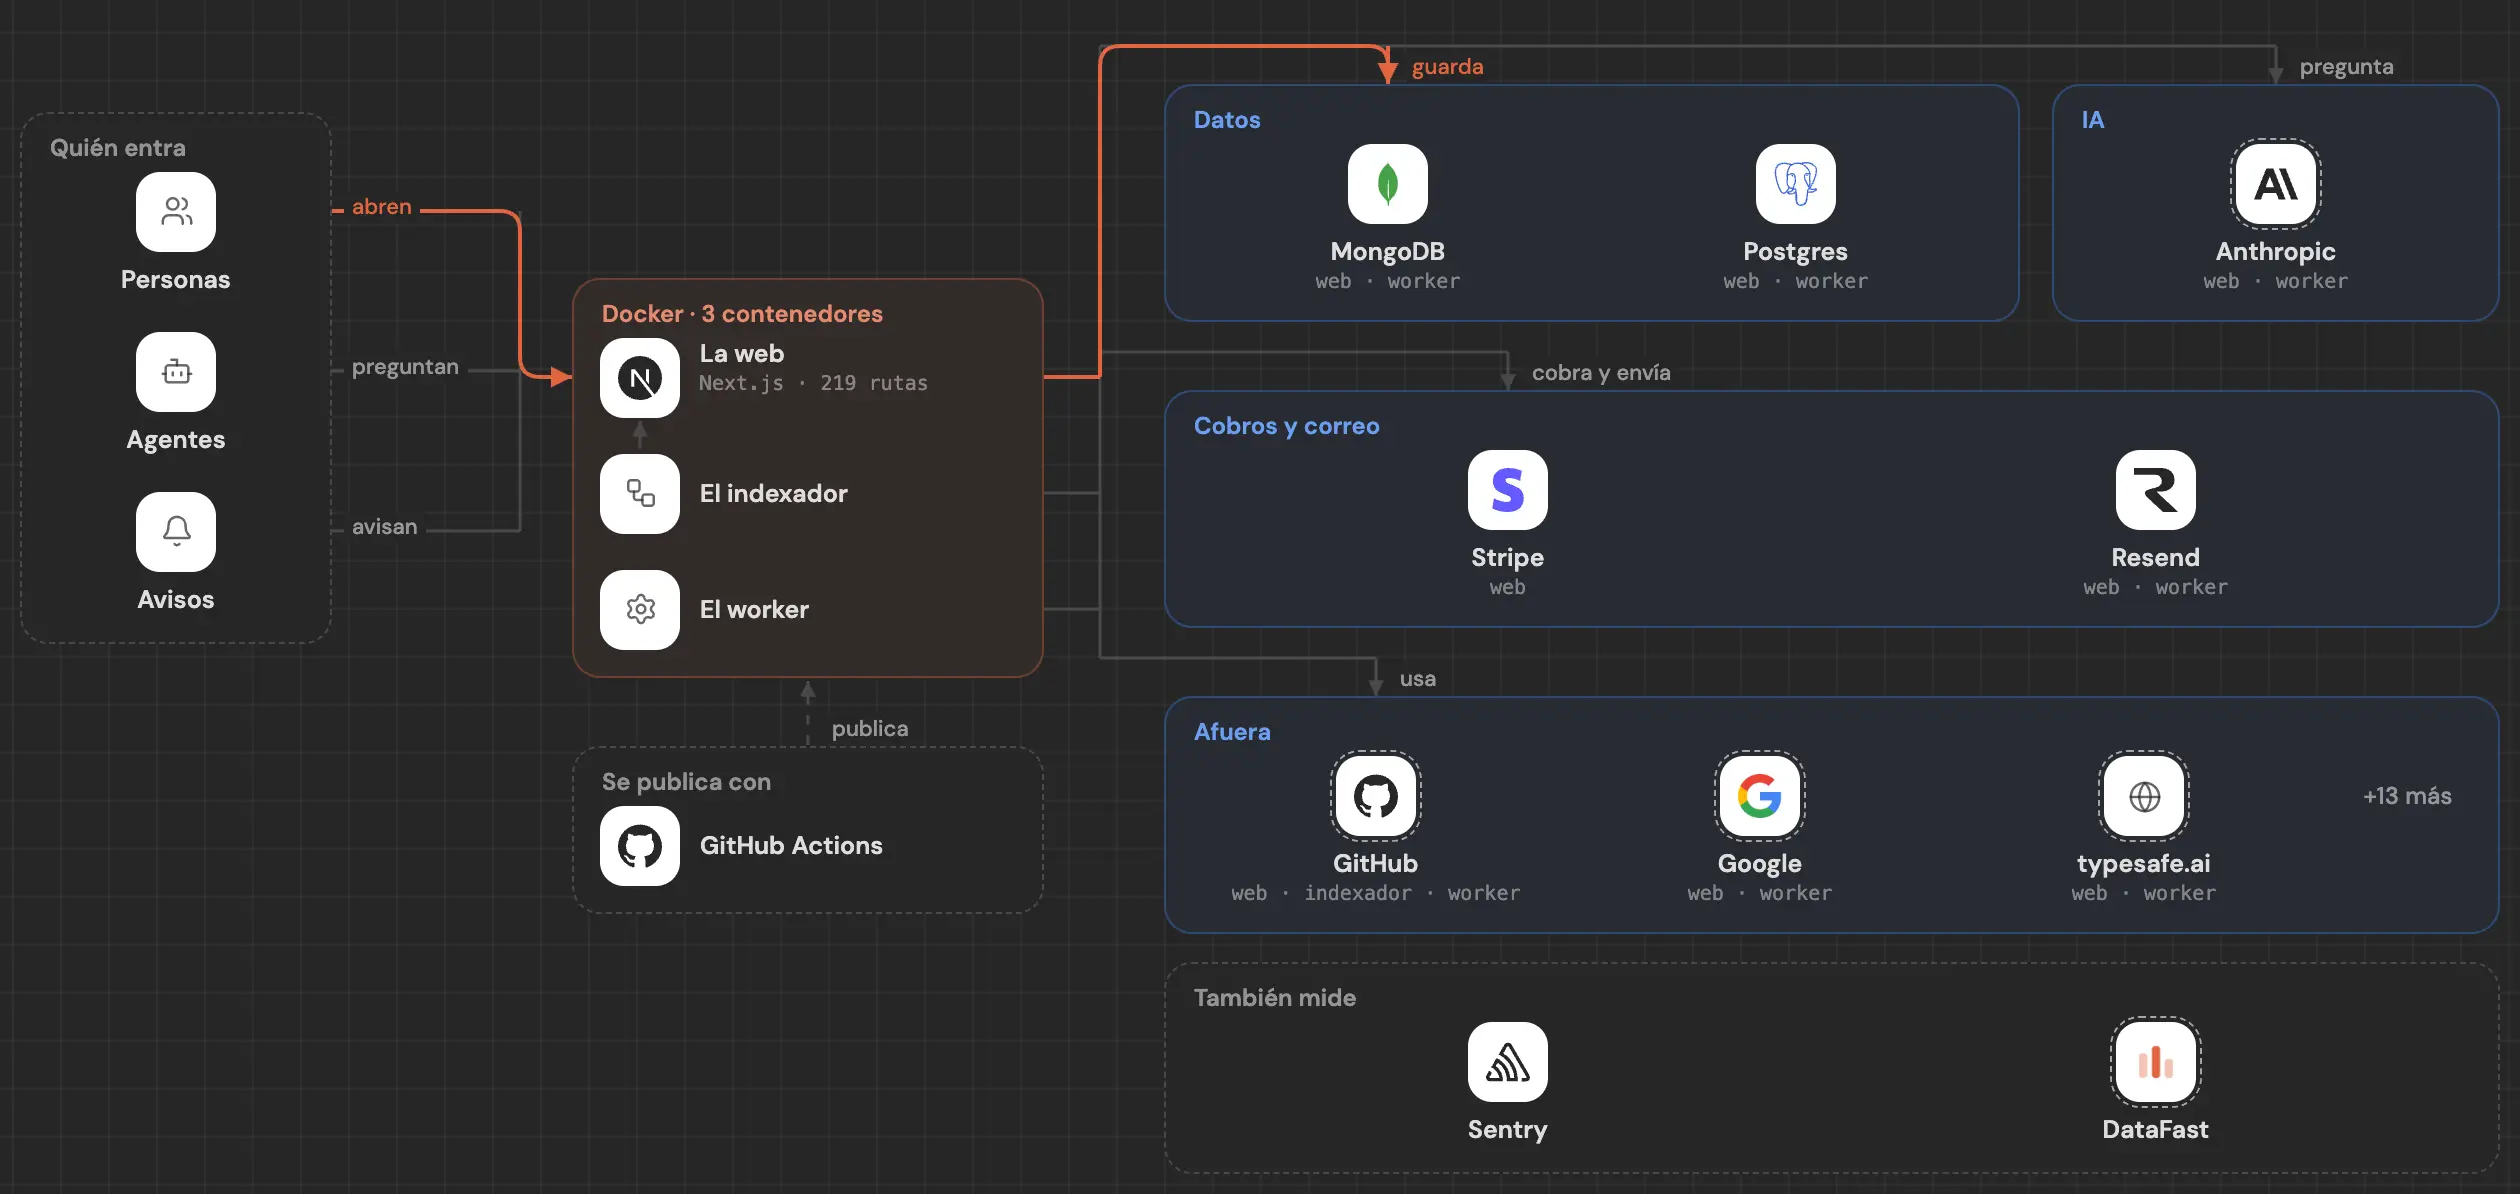
Mira tu código por dentro, hoy.
Pega tu repo y lo ves dibujado, parte por parte: uno mediano, en menos de un minuto.
Gratis y sin cuenta.


