¿Con qué está hecho pdfplumber?
pdfplumber es un repo de Python. Arma su contenido con pdfminer.six, pillow y pypdfium2 y se prueba con pytest-cov, pytest-xdist y Pytest. Son 8,335 líneas escritas, con 17 archivos de prueba.
 LinkedIn
Leído el 13 de noviembre de 2026, en el commit 4c64b92. Léela en markdown
La ficha dice con qué está hecho. Su mapa entero lo abre por dentro: cada parte del código y cómo se conecta con las demás.
Apoyo
Contenido 3
pillow1 archivo
pdfminer.six
- pypdfium21 archivo
Pruebas 3
- Pytest7 archivos
pytest-cov
pytest-xdist
Herramientas 8
- Black
isort
jupyterlab
pandas-stubs
- Setuptools
- flake8
- mypy
- types-pillow
Otras 2
- pandas2 archivos
- py
Otros repos con un stack parecido
Ordenados por cuánto de su stack comparten con pdfplumber, y después por estrellas.
- ocrmypdfOCRmyPDF35.4 k
OCRmyPDF adds an OCR text layer to scanned PDF files, allowing them to be searched
3 de 16 en comúnComparar → - srbhrResume-Matcher29.4 k
The #1 AI Harness for Building Resumes, PDFs, Cover Letters & more, locally with 100+ LLMs support.
3 de 16 en común · TypeScriptComparar → - arc53DocsGPT18.4 k
Private AI platform for agents, assistants and enterprise search. Built-in Agent Builder, Deep research, Document analysis, Multi-model support, and API connectivity for agents.
3 de 16 en comúnComparar → - microsoftmarkitdown195.7 k
Python tool for converting files and office documents to Markdown.
2 de 16 en común - Significant-GravitasAutoGPT188.1 k
AutoGPT is the vision of accessible AI for everyone, to use and to build on. Our mission is to provide the tools, so that you can focus on what matters.
2 de 16 en común
Preguntas frecuentes
¿En qué lenguaje está escrito pdfplumber?
¿pdfplumber tiene pruebas?
¿Qué repos tienen un stack parecido a pdfplumber?
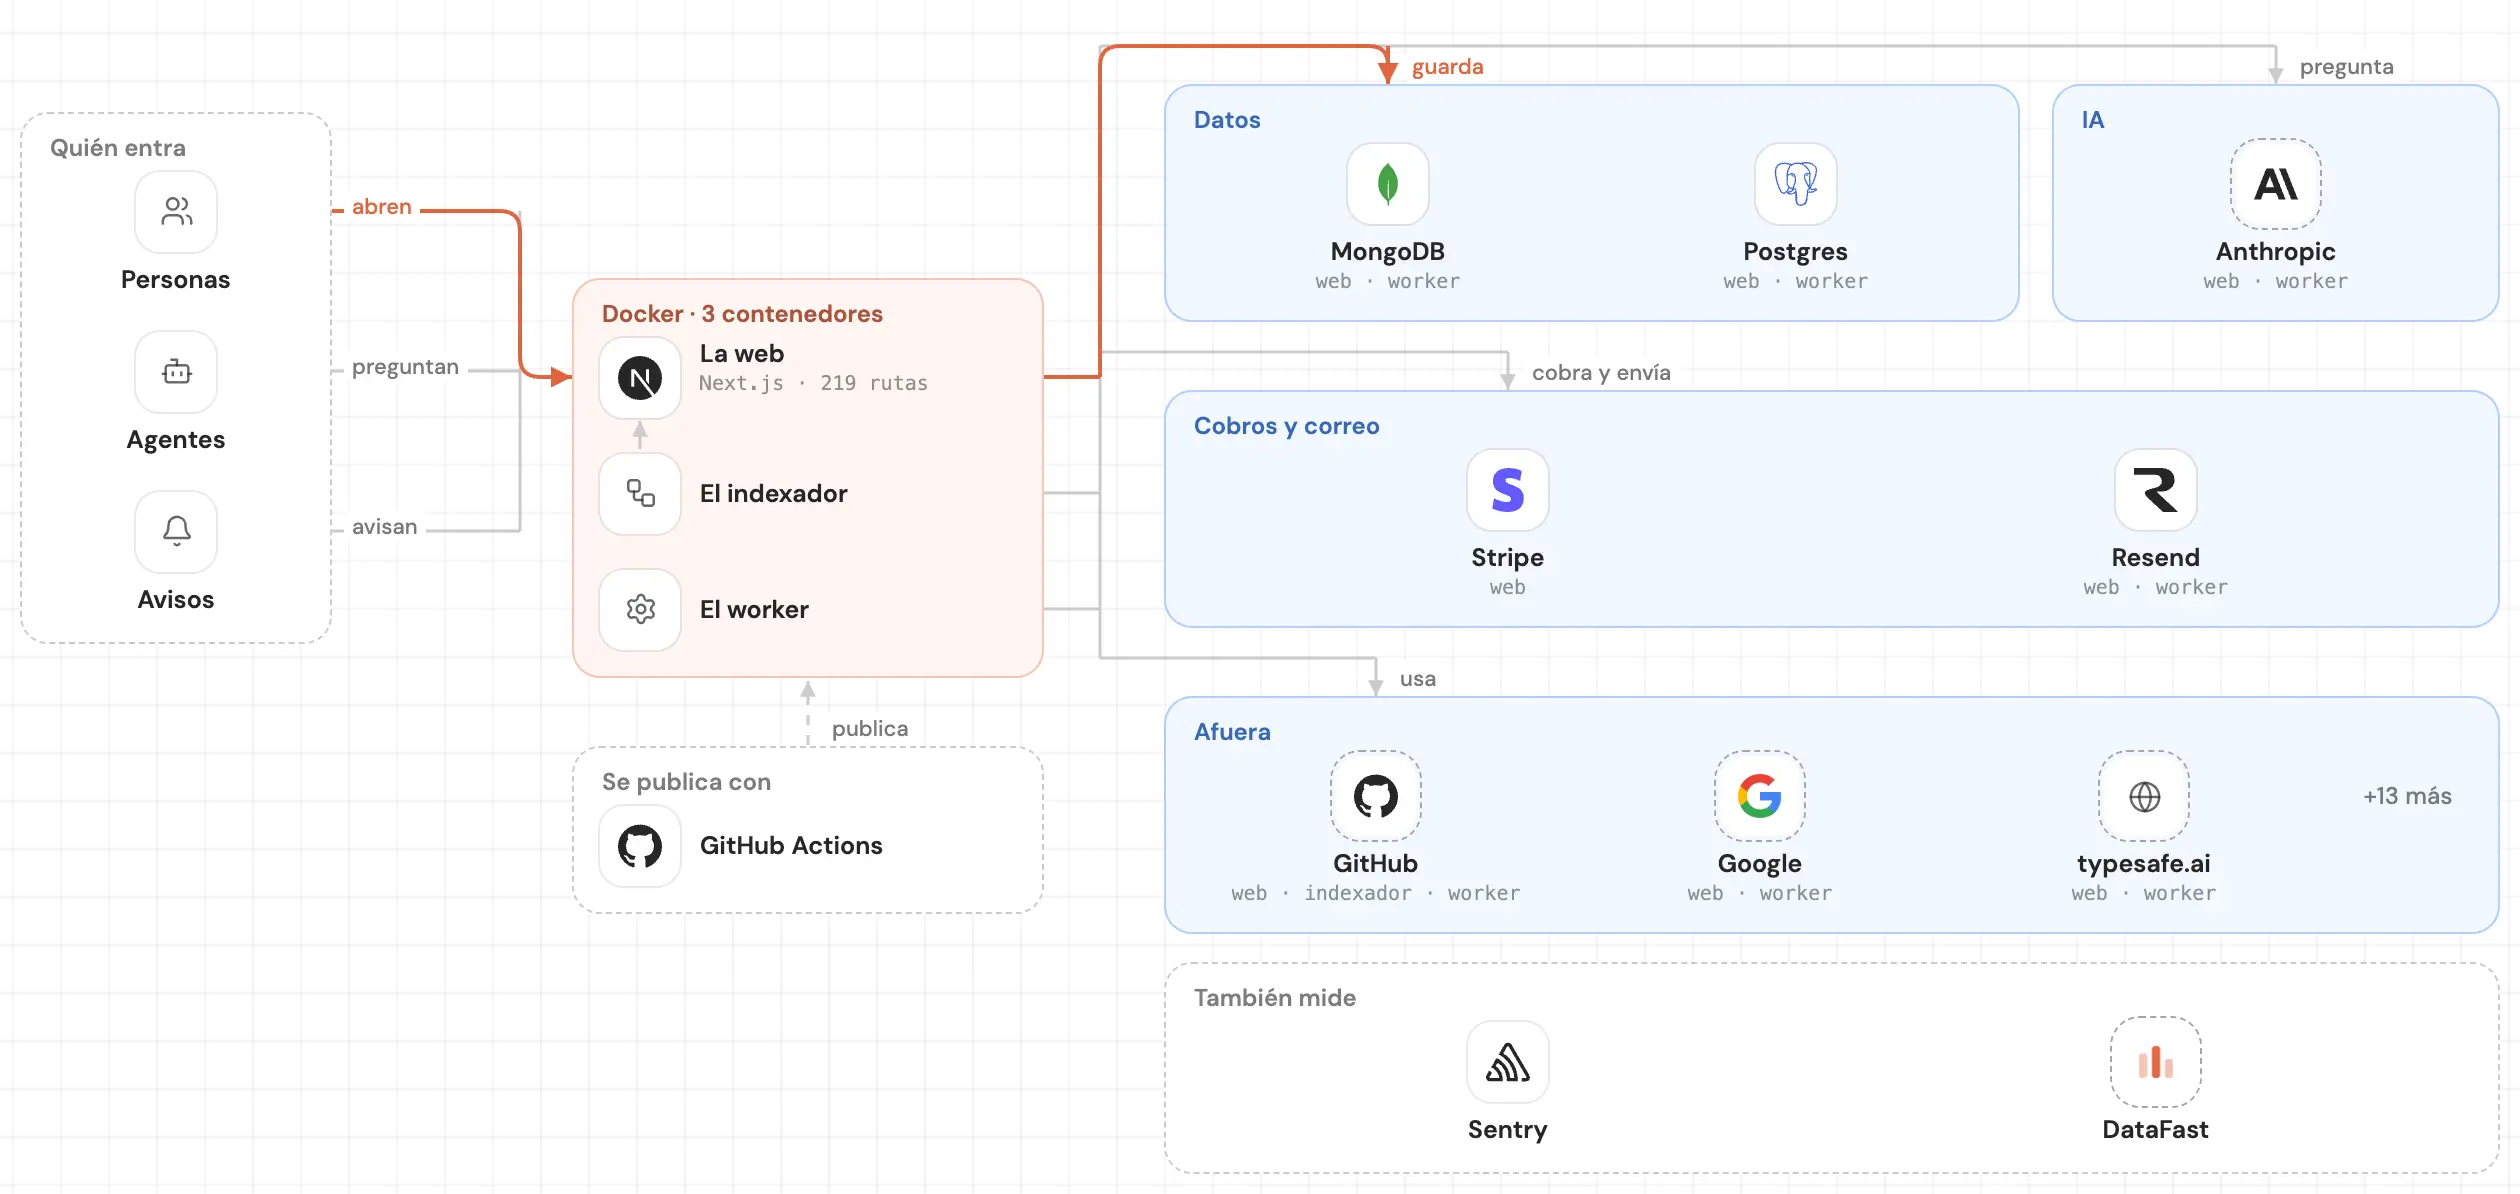
Mira tu código por dentro, hoy.
Pega tu repo y lo ves dibujado, parte por parte: uno mediano, en menos de un minuto.
Gratis y sin cuenta.¿Repo privado? Entra con GitHub


